
Analizador headless de Ghidra: qué es y cuándo usarlo
El analizador headless de Ghidra es el punto de entrada de línea de comandos para ejecutar análisis sin abrir el escritorio. Puede crear o completar un proyecto, analizar programas importados o existentes y ejecutar scripts sin interfaz para carpetas de muestras, triaje de firmware, informes programados o canalizaciones controladas.
Headless no es un servidor remoto y no convierte todas las conclusiones en automáticas. El lanzador sigue dependiendo de la instalación de Ghidra, la ubicación del proyecto, los cargadores, los analizadores, los scripts y las reglas normales del proyecto. Registra la versión, las entradas, las opciones, el proyecto de salida y el log; analiza únicamente material para el que tengas autorización.
La documentación oficial y el lanzador support/analyzeHeadless de la versión instalada definen las opciones disponibles. Esta página explica un flujo seguro, pero no sustituye la ayuda incluida con tu versión de Ghidra.
Prepara la instalación, el proyecto y los archivos de entrada
Comienza con el ZIP oficial de Ghidra y un JDK de 64 bits compatible. La versión comprobada para este sitio es Ghidra 12.1.3, publicada el 18 de agosto de 2026, y su archivo incluye el lanzador dentro de support/. Consulta la guía de instalación de Ghidra si la aplicación de escritorio todavía no inicia; un JDK roto o una extracción incompleta también rompe las ejecuciones headless.
Mantén separados la aplicación, el proyecto y las carpetas de entradas e informes. No edites un proyecto activo desde un trabajo por lotes ni sobrescribas una copia conocida como buena antes de revisar la nueva ejecución. Usa un nombre de proyecto nuevo mientras pruebas scripts u opciones de análisis.
- 1
Confirma el lanzador
Desde la instalación de Ghidra, comprueba que existe el lanzador de tu plataforma y que puede mostrar la ayuda. Windows usa el archivo por lotes; macOS y Linux usan el lanzador de shell.
support/analyzeHeadless.bat O support/analyzeHeadless - 2
Elige una raíz de proyecto escribible
Usa una carpeta con espacio suficiente para programas importados, bases de datos, cachés e informes. Evita una carpeta sincronizada mientras investigas bloqueos o escrituras concurrentes.
D:\analysis\projects /srv/ghidra/projects - 3
Registra las entradas
Anota los nombres, hashes, arquitecturas esperadas y fecha de recopilación. Una ruta de directorio no es una entrada reproducible si no registras su contenido.
samples/firmware-a.bin samples/firmware-b.bin - 4
Haz una copia antes de procesar
Copia el proyecto antes de ejecutar un script que cambie nombres, tipos de datos, programas o información guardada.
ProjectName.gpr + ProjectName.rep/
Elige entre -import y -process
La decisión principal del analizador headless es si el comando debe crear o completar un proyecto a partir de archivos, o volver a abrir programas que ya están en un proyecto. Usa -import cuando un archivo o directorio deba convertirse en programas del proyecto. Usa -process cuando el proyecto ya contenga el programa.
No añadas ambos modos solo porque aparezcan juntos en un ejemplo de internet. Empieza con un trabajo explicable, especifica el cargador o el procesador únicamente cuando sea necesario y guarda el comando que funcionó en un script versionado.
| Tarea | Modo | Entrada habitual | Qué verificar |
|---|---|---|---|
| Crear un proyecto desde binarios | -import | Archivo o directorio | Cargador, lenguaje y nombre del proyecto |
| Analizar programas ya guardados | -process | Proyecto existente | Nombres de programas y copia del proyecto |
| Ejecutar un script durante la importación | -import + -postScript | Nuevas entradas | Ruta del script y salida guardada |
| Procesar un árbol de programas | -process + -recursive | Árbol del proyecto | Alcance y log de cada ejecución |
cd C:\ghidra_12.1.3_PUBLIC\support
analyzeHeadless.bat D:\analysis\projects HeadlessDemo -import D:\analysis\samples\demo.exe./support/analyzeHeadless /srv/ghidra/projects HeadlessDemo -process demo.exeUsa scripts sin perder la reproducibilidad
Los trabajos headless son más útiles cuando un script convierte el estado del análisis en un resultado pequeño y revisable. Un pre-script puede preparar una acción del proyecto; un post-script puede inspeccionar el programa analizado y escribir un informe. Mantén los scripts acotados: imprimir funciones, cadenas, imports o un campo de metadatos es más fácil de probar que renombrar silenciosamente un proyecto grande.
Guarda los scripts en un directorio versionado y pásalo con -scriptPath. Usa -preScript y -postScript y conserva los logs compatibles. Si necesitas CPython fuera de Ghidra, consulta la guía de PyGhidra.
- Empieza con una tarea de solo lectura o de generación de informes y una muestra pequeña autorizada.
- Fija la revisión del script junto al comando y a la versión de Ghidra.
- Escribe los informes fuera del directorio del proyecto salvo que el script tenga que guardar datos del proyecto.
- Prueba un resultado vacío, un campo ausente y una segunda ejecución.
Directorios por lotes, logs y trabajos de CI
Para un flujo basado en directorios, decide si los archivos deben compartir un proyecto o usar proyectos aislados. Un solo proyecto facilita la navegación entre archivos; los proyectos separados reducen el riesgo de mezclar datos por accidente. Usa -recursive solo cuando las carpetas anidadas formen parte del alcance, porque una ruta amplia puede importar más datos de los esperados.
Registra el comando, las versiones, el manifiesto, la revisión del script, el estado de salida, los logs y los resultados inesperados. En CI, conserva informes y marca un error si el lanzador o el post-script falla.
El mismo comando puede producir conclusiones distintas si cambian la carpeta de entradas, el perfil del proyecto, las extensiones, la revisión del script o la versión de Ghidra. Registra esos límites junto al informe.
./support/analyzeHeadless /srv/ghidra/projects BatchSet -import /srv/ghidra/samples -recursive -scriptPath /srv/ghidra/scripts -postScript export_summary.pyrelease=12.1.3 input_manifest=sha256.csv script=export_summary.py@abc123 project=BatchSet log=run-2026-09-16.logLee el resultado y verifícalo en Ghidra
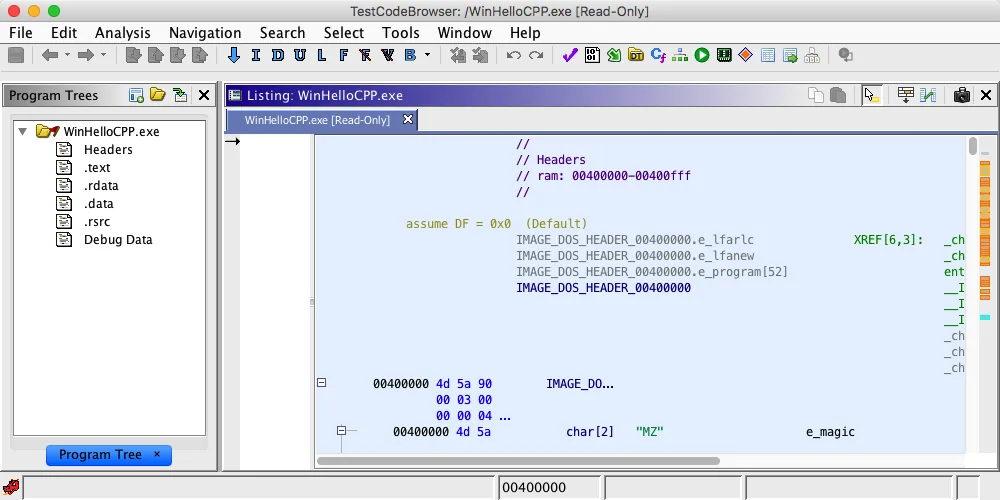
Después de una ejecución headless, revisa el estado de salida y el log antes de abrir el proyecto. Comprueba los mensajes del cargador, el lenguaje o compilador elegido, la finalización del análisis, las excepciones de scripts, los archivos omitidos y los fallos de escritura. Luego abre una copia en la interfaz y verifica una pequeña muestra en Listing, referencias, Decompiler o símbolos. La guía de búsqueda de Ghidra y la guía del Decompiler describen estas comprobaciones.
Un informe es un artefacto, no una prueba por sí solo. Si no aparecen cadenas, confirma el lenguaje, el alcance y el objeto de la API.
| Síntoma | Primera comprobación | Siguiente paso seguro |
|---|---|---|
| No aparece ningún programa | Modo de importación, ruta y cargador | Ejecuta un archivo con un nombre de proyecto nuevo |
| No se encuentra el script | Ruta y nombre del archivo | Usa un directorio de scripts absoluto y un script mínimo |
| El análisis queda incompleto | Log, tiempo de espera, memoria y mensajes | Repite una muestra y compara la copia del proyecto |
| La salida difiere de la GUI | Versión, lenguaje, opciones y fase del script | Verifica el mismo programa y ajustes en ambos caminos |
Preguntas frecuentes sobre el analizador headless de Ghidra
¿Dónde está analyzeHeadless en Ghidra?
Está en el directorio support/ de la instalación de Ghidra. Windows incluye analyzeHeadless.bat; Linux y macOS usan el lanzador de shell. Usa el lanzador que pertenece a la versión instalada.
¿Cuál es la diferencia entre -import y -process?
Usa -import cuando el trabajo empieza con archivos o directorios y debe crear o completar un proyecto. Usa -process cuando los programas ya están dentro del proyecto y deben procesarse.
¿Puede Ghidra analizar muchos archivos sin la GUI?
Sí. El analizador headless puede importar o procesar un directorio, y opciones como -recursive pueden ampliar el alcance previsto. Empieza con un conjunto autorizado pequeño y registra el manifiesto para poder revisar el resultado.
¿Puedo ejecutar un script con analyzeHeadless?
Sí. Usa las opciones de ruta, pre-script y post-script compatibles con la versión instalada. Mantén los scripts versionados, pruébalos en una copia y guarda logs e informes junto al registro del comando.
¿El analizador headless es lo mismo que PyGhidra?
No. El analizador headless es el lanzador CLI para imports y procesamiento de proyectos. PyGhidra conecta un proceso CPython externo con la API de Ghidra; elige según la frontera de automatización que necesites.