
Analisador headless do Ghidra: o que é e quando usar
O analisador headless do Ghidra é a entrada de linha de comando para executar análises sem abrir o aplicativo desktop. Ele pode criar ou completar um projeto, analisar programas importados ou existentes e executar scripts sem interface para pastas de amostras, triagem de firmware, relatórios agendados ou pipelines controlados.
Headless não é um servidor remoto e não torna todas as conclusões automáticas. O lançador ainda depende da instalação do Ghidra, do local do projeto, dos loaders, dos analisadores, dos scripts e das regras normais do projeto. Registre a versão, o conjunto de entradas, as opções, o projeto de saída e o log; analise somente material para o qual você tenha autorização.
A documentação oficial e o lançador support/analyzeHeadless da versão instalada definem as opções disponíveis. Esta página explica um fluxo cuidadoso, mas não substitui a ajuda incluída na sua versão do Ghidra.
Prepare a instalação, o projeto e os arquivos de entrada
Comece com o ZIP oficial do Ghidra e um JDK de 64 bits compatível. A versão verificada para este site é o Ghidra 12.1.3, publicado em 18 de agosto de 2026, e o arquivo inclui o lançador em support/. Consulte o guia de instalação do Ghidra se o aplicativo desktop não iniciar; um JDK com problema ou uma extração incompleta também interrompe execuções headless.
Mantenha o aplicativo, o projeto e as pastas de entrada e relatório separados. Não edite um projeto ativo a partir de um job em lote nem sobrescreva uma cópia conhecida como boa antes de revisar a nova execução. Use um nome de projeto novo ao testar scripts ou opções de análise.
- 1
Confirme o lançador
Na instalação do Ghidra, verifique se o lançador da sua plataforma existe e consegue mostrar a ajuda. O Windows usa o arquivo batch; macOS e Linux usam o lançador de shell.
support/analyzeHeadless.bat OU support/analyzeHeadless - 2
Escolha uma raiz de projeto gravável
Reserve espaço suficiente para programas importados, bancos de dados, caches e relatórios. Evite uma pasta sincronizada enquanto investiga bloqueios ou gravações simultâneas.
D:\analysis\projects /srv/ghidra/projects - 3
Registre o conjunto de entradas
Anote nomes de arquivos, hashes, arquiteturas esperadas e data da coleta. Um caminho de diretório não é uma entrada reproduzível se o conteúdo não estiver registrado.
samples/firmware-a.bin samples/firmware-b.bin - 4
Faça backup antes de processar
Copie o projeto antes de executar um script que renomeie símbolos, altere tipos de dados, remova programas ou salve dados atualizados.
ProjectName.gpr + ProjectName.rep/
Escolha entre -import e -process
A decisão principal do analisador headless é saber se o comando deve criar ou completar um projeto a partir de arquivos, ou reabrir programas que já estão em um projeto. Use -import quando um arquivo ou diretório deve virar programas do projeto. Use -process quando o projeto já contém o programa.
Não adicione os dois modos apenas porque um exemplo na internet os mostra juntos. Comece com um job explicável, informe um loader ou processador somente quando necessário e salve o comando bem-sucedido em um script versionado.
| Tarefa | Modo | Entrada comum | O que verificar |
|---|---|---|---|
| Criar um projeto a partir de binários | -import | Arquivo ou diretório | Loader, linguagem e nome do projeto |
| Analisar programas já salvos | -process | Projeto existente | Nomes dos programas e cópia do projeto |
| Executar um script durante a importação | -import + -postScript | Novo conjunto de entradas | Caminho do script e saída salva |
| Processar uma árvore de programas | -process + -recursive | Árvore do projeto | Escopo e log de cada execução |
cd C:\ghidra_12.1.3_PUBLIC\support
analyzeHeadless.bat D:\analysis\projects HeadlessDemo -import D:\analysis\samples\demo.exe./support/analyzeHeadless /srv/ghidra/projects HeadlessDemo -process demo.exeUse scripts sem perder a repetibilidade
Jobs headless ficam mais úteis quando um script transforma o estado da análise em um resultado pequeno e revisável. Um pre-script pode preparar uma ação do projeto; um post-script pode inspecionar o programa analisado e escrever um relatório. Mantenha os scripts estreitos: imprimir funções, strings, imports ou um campo de metadados é mais fácil de testar do que renomear silenciosamente um projeto grande.
Coloque os scripts em um diretório versionado e passe-o com -scriptPath. Use -preScript e -postScript e guarde os logs. Se precisar de CPython fora do Ghidra, consulte o guia do PyGhidra.
- Comece com uma tarefa de leitura ou geração de relatório e uma amostra pequena e autorizada.
- Fixe a revisão do script ao lado do comando e da versão do Ghidra.
- Escreva relatórios fora do diretório do projeto quando possível.
- Teste um resultado vazio e uma segunda execução.
Diretórios em lote, logs e jobs de CI
Em um fluxo baseado em diretório, decida se os arquivos devem compartilhar um projeto ou usar projetos isolados. Um projeto único facilita a navegação entre arquivos; projetos separados reduzem a mistura acidental. Use -recursive somente quando pastas aninhadas fizerem parte do escopo, pois um caminho amplo pode importar mais dados do que o esperado.
Registre o comando, as versões, o manifesto, a revisão do script, o status de saída, os logs e os resultados inesperados. No CI, arquive relatórios e falhe quando o lançador ou o post-script informar um problema.
O mesmo comando pode produzir conclusões diferentes quando mudam a pasta de entrada, o perfil do projeto, as extensões, a revisão do script ou a versão do Ghidra. Registre esses limites ao lado do relatório.
./support/analyzeHeadless /srv/ghidra/projects BatchSet -import /srv/ghidra/samples -recursive -scriptPath /srv/ghidra/scripts -postScript export_summary.pyrelease=12.1.3 input_manifest=sha256.csv script=export_summary.py@abc123 project=BatchSet log=run-2026-09-16.logLeia o resultado e verifique-o no Ghidra
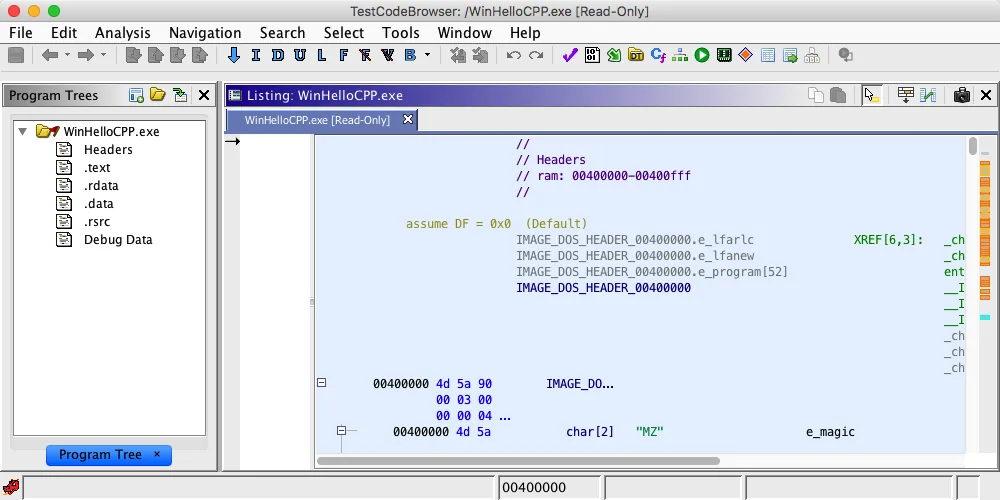
Depois de uma execução headless, confira o status de saída e o log antes de abrir o projeto. Verifique mensagens do loader, linguagem ou compilador escolhido, conclusão da análise, exceções de scripts, arquivos ignorados e falhas de gravação. Depois, abra uma cópia na GUI e confira uma pequena amostra em Listing, referências, Decompiler ou símbolos. O guia de busca do Ghidra e o guia do Decompiler ajudam nessa verificação.
Um relatório é um artefato, não uma prova por si só. Se não houver strings, confirme a linguagem, o escopo e o objeto da API.
| Sintoma | Primeira verificação | Próximo passo seguro |
|---|---|---|
| Nenhum programa aparece | Modo de importação, caminho e loader | Execute um arquivo com um novo nome de projeto |
| O script não é encontrado | Caminho e nome do arquivo | Use um diretório absoluto de scripts e um script mínimo |
| A análise fica incompleta | Log, tempo limite, memória e mensagens | Repita uma amostra e compare a cópia do projeto |
| A saída difere da GUI | Versão, linguagem, opções e fase do script | Verifique o mesmo programa e as configurações nos dois caminhos |
FAQ do analisador headless do Ghidra
Onde fica o analyzeHeadless no Ghidra?
Ele fica no diretório support/ da instalação do Ghidra. O Windows fornece analyzeHeadless.bat; Linux e macOS usam o lançador de shell. Use o lançador correspondente à versão instalada.
Qual é a diferença entre -import e -process?
Use -import quando o job começa com arquivos ou diretórios e precisa criar ou completar um projeto. Use -process quando os programas já estão no projeto e precisam ser processados.
O Ghidra pode analisar muitos arquivos sem a GUI?
Sim. O analisador headless pode importar ou processar um diretório, e opções como -recursive podem ampliar o escopo previsto. Comece com um conjunto pequeno e autorizado e registre o manifesto para conferir o resultado.
Posso executar um script com analyzeHeadless?
Sim. Use as opções de caminho do script, pre-script e post-script aceitas pela versão instalada. Versione os scripts, teste-os em uma cópia e guarde logs e relatórios junto ao registro do comando.
O analisador headless é igual ao PyGhidra?
Não. O analisador headless é o lançador CLI para imports e processamento de projetos. O PyGhidra conecta um processo CPython externo à API do Ghidra.