
Ghidra vs. IDA Pro: die kurze Entscheidung
Ghidra passt, wenn keine Lizenzkosten, ein einsehbarer Quellcode, ein leistungsfähiger Decompiler und wiederholbare Skripte wichtig sind. Das erleichtert Unterricht, interne Schulungen und gemeinsam reproduzierbare Laborumgebungen.
IDA Pro passt, wenn ein Team seine interaktive Arbeitsweise, vorhandene Schulung, bestimmte Prozessor- oder Hex-Rays-Module und kommerziellen Support priorisiert. Der Preis kann sich lohnen, wenn Analystenzeit und bestehende Datenbanken geschützt werden sollen.
Vergleichen Sie beide mit derselben erlaubten Probe, Architektur und Frage. Prüfen Sie die Instruktionen hinter dem Pseudocode und bewahren Sie Hash, Version, Annahmen und manuelle Bestätigung auf.
Vergleichen Sie beide mit derselben erlaubten Probe, Architektur und Frage. Prüfen Sie die Instruktionen hinter dem Pseudocode und bewahren Sie Hash, Version, Annahmen und manuelle Bestätigung auf.
Wann Ghidra oder IDA Pro besser passt
Ghidra ist ein pragmatischer Start für ein begrenztes Budget, offene Erweiterbarkeit, Unterricht oder Headless-Batches. Planen Sie Zeit für Projekte, Java, PyGhidra und Versionspflege ein.
IDA Pro ist sinnvoll, wenn die vorhandene Teamroutine täglich Zeit spart oder ein bestimmtes Modul standardisiert ist. Beziehen Sie Lizenz, Updatepolitik, Pluginpflege und Migration in die Rechnung ein.
Eine Mischstrategie ist möglich: Ghidra für reproduzierbares Triage und IDA Pro für eine schwierige Architektur oder eine etablierte Review. Kennzeichnen Sie jedes Ergebnis mit dem verwendeten Tool.
Was der Ghidra Decompiler leistet und was nicht
Ghidra analysiert Befehle, Kontrollfluss, Aufrufkonventionen, Symbole und Datentypen und stellt eine Funktion als lesbaren Pseudocode dar. Besonders hilfreich ist der Decompiler beim Erkennen von Verzweigungen, Schleifen, Argumenten, Rückgabewerten sowie Beziehungen zwischen aufrufenden und aufgerufenen Funktionen.
Die Ausgabe ist nicht der ursprüngliche C- oder C++-Quellcode. Optimierungen entfernen Namen und Typen, verbinden Ausdrücke, ordnen Arbeit neu und betten Funktionen ein. Behandle Namen, Typen und Ausdrücke als Arbeitshypothesen. Eine belastbare Aussage muss auch zu den Adressen im Listing und zu den umliegenden Referenzen passen.
Diese Seite behandelt gezielt den Decompiler. Projektanlage, Dateiimport, Auto Analysis und CodeBrowser-Grundlagen findest du im Ghidra-Tutorial für Einsteiger.
Pseudocode ist eine gut lesbare Karte des Maschinenverhaltens, aber kein Beweis für den ursprünglichen Quellcode.
Decompiler öffnen und mit dem Listing synchronisieren
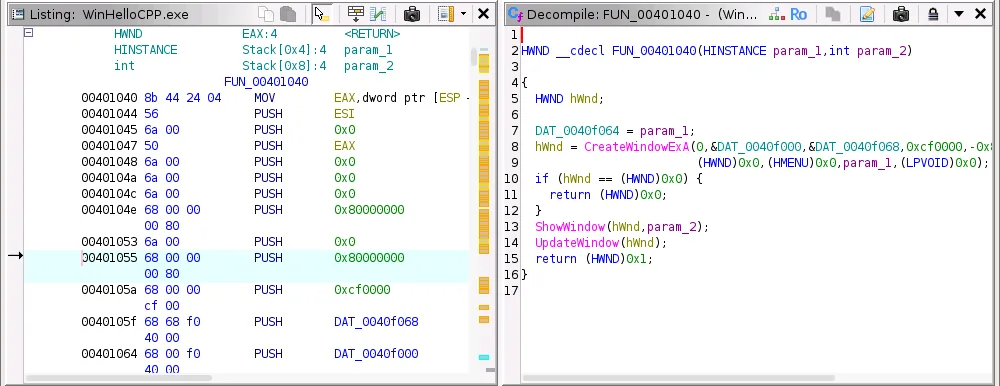
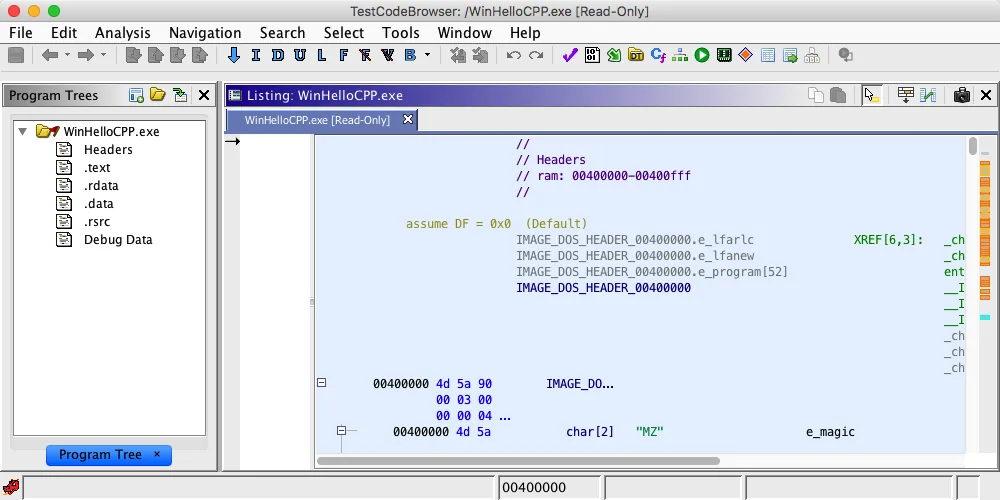
Öffne das Programm nach Abschluss von Auto Analysis im CodeBrowser. Ist das Fenster ausgeblendet, wähle Window > Decompiler. Sobald du im Listing oder Symbol Tree eine definierte Funktion auswählst, zeigt der Decompiler diese Funktion und hebt die zur aktuellen Anweisung gehörende Zeile hervor.
Beginne mit einem verlässlichen Anker: einer eindeutigen Zeichenfolge, einem importierten API-Aufruf, einem exportierten Symbol, einer Fehlermeldung oder einem bekannten Einstiegspunkt. Folge den Referenzen zur aufrufenden Funktion und warte das Ende der Hintergrundanalyse ab.
Meldet Ghidra, dass keine Funktion existiert, definiere Grenzen nur bei klaren Hinweisen in Disassembly und Referenzen. Bei falscher Prozessorsprache oder Image Base muss zuerst der Import korrigiert werden.
- 1
Anker wählen
Suche eine Zeichenfolge, ein Symbol, einen Import oder eine Adresse mit Bezug zum untersuchten Verhalten.
- 2
Referenz verfolgen
Öffne die verwendende Funktion und prüfe, dass Listing, Symbol Tree und Decompiler dieselbe Stelle zeigen.
- 3
Analyse abwarten
Lies danach Eingaben, Aufrufe, Bedingungen und Rückgabewert in einer festen Reihenfolge.
Ghidra-Pseudocode lesen, ohne ihn zu überschätzen
Lies zuerst Signatur, Rückgabetyp, Parameter und Aufrufkonvention. Bezeichnungen wie param_1, local_18, FUN_00401230 oder undefined8 bedeuten, dass Ghidra Belege fehlen. Sie stammen nicht aus dem Originalprogramm. Verfolge Herkunft, Veränderung und Verwendung jedes Wertes.
Suche anschließend Bedingungen, Schleifen, Aufrufe, Speicherzugriffe und Rückgabepfade. Öffne aufgerufene Funktionen, kehre über die Navigation zurück und prüfe Referenzen, bevor du einem Aufruf eine Bedeutung gibst. Cross-Highlighting verbindet einen Pseudocode-Ausdruck mit seinem Anweisungsbereich.
Compileroptimierung kann einfache Ausdrücke kompliziert erscheinen lassen oder mehrere Operationen zu sauberem Pseudocode zusammenziehen. Kontrolliere Sprungrichtung, Konstanten, Vorzeichen, Zeigerarithmetik und Nebenwirkungen im Listing.
| Hinweis | Wahrscheinliche Bedeutung | Zu prüfen |
|---|---|---|
| param_1 / local_10 | Unbekannter Parameter oder lokale Variable | Nutzung, Stack, Aufrufer |
| FUN_... | Unbenannte Funktion | Aufrufer, Strings, Importe |
| undefined4 / undefined8 | Größe bekannt, Typ unsicher | Register, Casts, Speicherlayout |
| goto / ungewöhnliche Schleife | Rekonstruierter Kontrollfluss | Sprungziele und Function Graph |
| viele Casts | Typ- oder Signaturkonflikt | Vorzeichen, Zeiger, Prototyp |
Ausgabe mit Namen, Signaturen und Datentypen verbessern
Die Ausgabe wird besser, wenn das Projekt belastbare Fakten enthält. Benenne Funktionen erst um, wenn Aufrufe, Zeichenfolgen, Importe oder Datenfluss die Aufgabe belegen. Benenne Variablen nach ihrer Verantwortung und nutze Kommentare für Belege und Unsicherheiten, nicht als Wiederholung des Pseudocodes.
Eine falsche Signatur verteilt irreführende Casts und Zeigerarithmetik auf alle Aufrufer. Korrigiere Rückgabetyp, Parameter und Aufrufkonvention. Wende Strukturen, Enums, Arrays und Zeigertypen an, wenn wiederkehrende Offsets und Konstanten sie stützen.
Ändere jeweils nur eine belegte Annahme und kontrolliere danach die Aufrufer. So lässt sich eine plausible, aber falsche Interpretation schnell erkennen.
- 1
Stabile Symbole benennen
Verwende beschreibende Teilnamen nur dann, wenn sichtbare Belege die Aufgabe stützen.
- 2
Prototyp korrigieren
Kläre Rückgabe, Parameter, Konvention und Zeigertiefe vor lokalen Variablen.
- 3
Wiederverwendbare Typen anwenden
Erzeuge Strukturen oder Enums bei wiederkehrenden Offsets und Konstanten.
- 4
Aufrufer prüfen
Stelle sicher, dass die neue Signatur Nachbarfunktionen erklärt und keine Widersprüche erzeugt.
Aussagen im Listing und Function Graph bestätigen
Das Listing ist der adressgenaue Nachweis für dekodierte Befehle und Daten. Prüfe dort, welcher Vergleich einen Sprung steuert, ob ein Wert vorzeichenbehaftet ist, wohin ein Aufruf zurückkehrt und ob ein Speicherzugriff vor oder nach einer Kontrolle erfolgt.
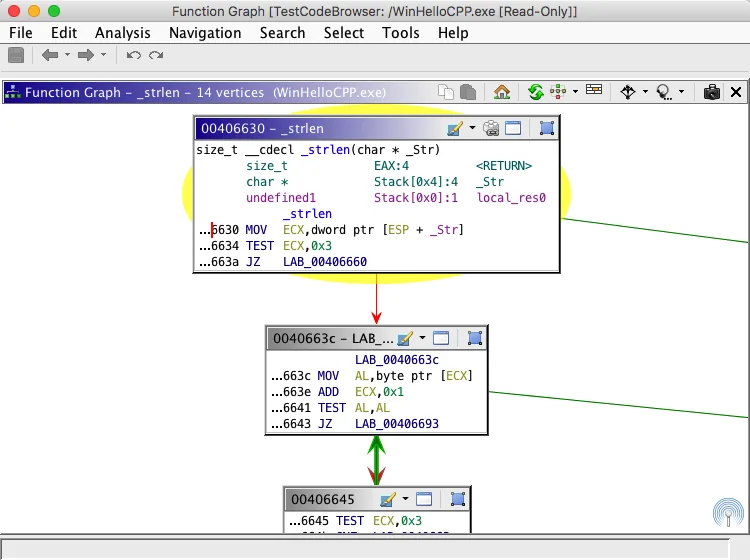
Bei verschachtelten Bedingungen, frühen Rückgaben und Schleifen zeigt der Function Graph die Kontrollflussblöcke. Folge den Wahr- und Falsch-Kanten, erkenne gemeinsame Blöcke und formuliere anschließend im Decompiler eine kurze Erklärung für jeden Pfad.
Notiere bei wichtigen Ergebnissen Funktionsadresse, entscheidende Anweisung oder Block, Referenzen und Sicherheit der Aussage. Diese Belege bleiben nützlich, selbst wenn spätere Typinformationen den Pseudocode verändern.
Warum die Decompiler-Ausgabe falsch oder unvollständig wirkt
Schlechte Ausgabe weist häufig auf fehlende Analysedaten hin. Prüfe Prozessorsprache, Compiler Specification, Speicherabbild, Image Base, Funktionsgrenzen, Signatur und Analyzer-Ergebnisse, bevor du einen Decompiler-Fehler annimmst.
Verschleierung, gepackter Code, handgeschriebener Assembler, indirekte Aufrufe, Ausnahmen, aggressive Optimierung und selbstverändernder Code begrenzen die Rekonstruktion. Untersuche dann gezielt einen Sprung, eine Struktur oder einen Aufrufer statt den gesamten Programmquelltext zu erwarten.
| Symptom | Wahrscheinliche Ursache | Nächste Prüfung |
|---|---|---|
| Keine Funktion | Grenzen nicht definiert | Referenzen und Disassembly |
| Unsinnige Befehle | Falsche Sprache oder Basis | Import und Speicherabbild |
| Zu viele Casts | Falsche Signatur oder Typen | Prototyp, Vorzeichen, Zeiger |
| Fehlende Aufrufe | Indirekter Fluss oder Analyselücke | XRefs und Aufrufstellen |
| Sehr komplexer Pseudocode | Optimierung oder Verschleierung | Kleinere Abschnitte und Function Graph |
Wiederholbarer 20-Minuten-Workflow
Nutze ein eigenes Programm, eine Open-Source-Binärdatei, eine Lernaufgabe oder eine Datei, die du untersuchen darfst. Importiere sie in einer isolierten Umgebung, führe Auto Analysis aus, suche eine Erfolgs- oder Fehlermeldung und erkläre die entscheidende Funktion in eigenen Worten.
Benenne nur belegte Symbole, korrigiere eine Signatur oder einen Typ, vergleiche die Hauptbedingung im Listing und nutze bei unklarem Kontrollfluss den Function Graph. Schreibe am Ende einen Satz als Ergebnis und notiere die stützenden Adressen. Automatisiere erst danach mit PyGhidra.
Details zur Bedienung stehen in der offiziellen Decompiler-Hilfe. Die aktuelle geprüfte Version installierst du mit der Ghidra-Installationsanleitung; sichere Projekte vor einem Upgrade.
- 0–5 Minuten: verlässlichen String, Import, Symbol oder Adresse finden.
- 5–10 Minuten: Eingaben, Aufrufe, Bedingungen, Schreibzugriffe und Rückgabe lesen.
- 10–15 Minuten: einen Namen, eine Signatur oder einen Typ belegt verbessern.
- 15–20 Minuten: entscheidenden Pfad prüfen und Ergebnis mit Adressen notieren.
Ghidra und IDA Pro: FAQ
Ist Ghidra besser als IDA Pro?
Keines ist allgemein besser. Ghidra überzeugt durch kostenlose Verteilung und offene Automatisierung; IDA Pro passt oft zu kommerziellen Teams, bestimmten Prozessoren und bestehendem Know-how.
Hat Ghidra einen Decompiler wie IDA Pro?
Ja. Ghidra liefert C-ähnliches Pseudocode. Vergleiche beide am gleichen Programm und bestätige wichtige Aussagen in der Disassembly.
Darf ich beide am selben Binärprogramm nutzen?
Ja, sofern Lizenz und Analyseerlaubnis es erlauben. Projekte, Hashes und Ergebnisse sollten getrennt dokumentiert werden.
Welches Tool ist für Einsteiger besser?
Ghidra ist wegen der kostenlosen, vollständigen Lernumgebung ein guter Start. In einem IDA-Team kann der bestehende Review-Prozess wichtiger sein.
Braucht ein Bericht Screenshots?
Screenshots helfen beim Orientieren. Entscheidend sind jedoch Adresse, Instruktionen, Version, Annahmen und manuelle Bestätigung.