
Ghidra 펌웨어 분석: 실행 파일 분석과 무엇이 다른가요?
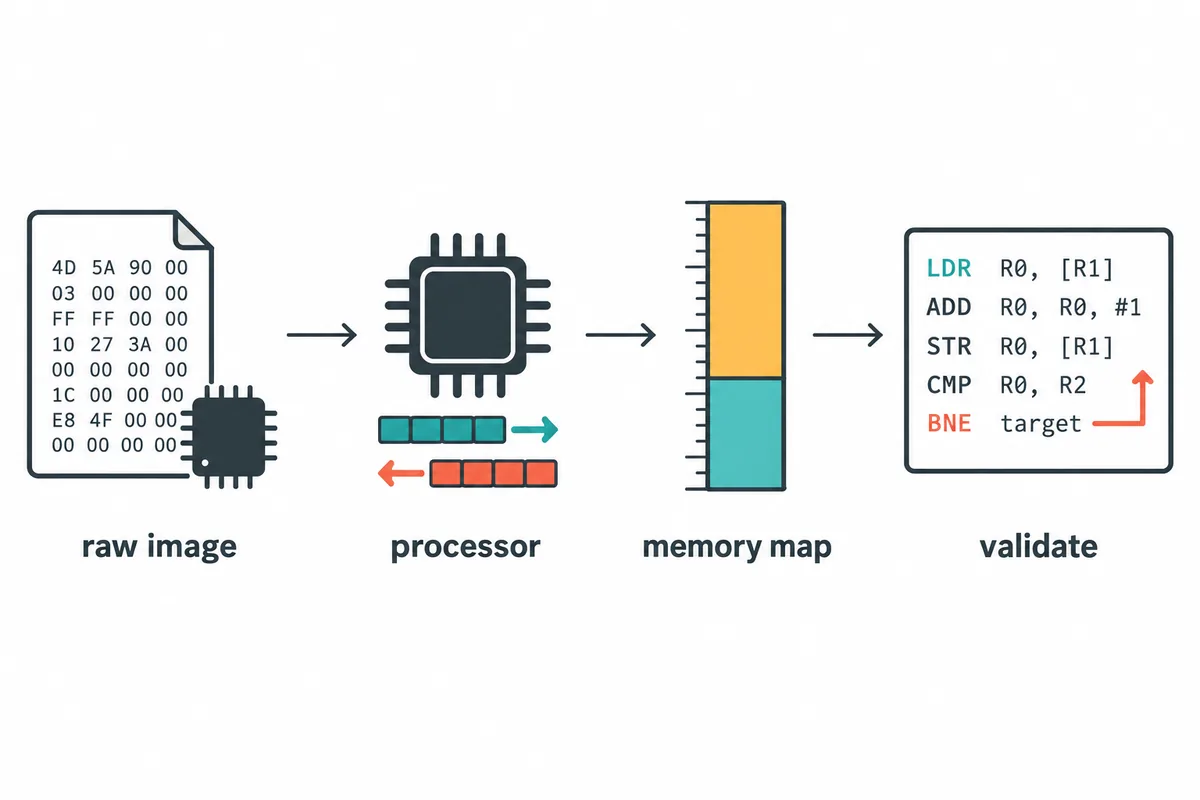
PE와 ELF 실행 파일에는 섹션, 머신 유형, 로드 정보를 설명하는 헤더가 있습니다. Raw 펌웨어 덤프는 부트로더, 애플리케이션, 상수, 패딩, RAM으로 복사되는 데이터를 섞어 담은 바이트열일 수 있으며 프로세서, 바이트 순서, 실행 주소가 파일에 기록되지 않을 수 있습니다.
Ghidra는 장치 정보를 추측해 채울 수 없습니다. 언어나 기준 주소가 틀려도 그럴듯한 명령어와 잘못된 참조가 나올 수 있습니다. 펌웨어 분석 설정은 데이터시트, 링커 맵, SDK, 부트로더 소스 또는 신뢰할 수 있는 장치 자료와 대조하세요.
| 입력 | Ghidra가 파악할 수 있는 내용 | 직접 확인할 내용 |
|---|---|---|
| PE 또는 ELF | 컨테이너 형식과 대개 머신 유형 | 특이한 섹션, 사용자 지정 로더, 실행 동작 |
| Raw 펌웨어 덤프 | 바이트와 일부 패턴 | 프로세서 언어, 엔디언, 로드 주소, 메모리 영역 |
| 여러 조각으로 추출한 파일 | 각 파일을 별도의 바이트 범위로 처리 | 조각과 장치 주소 사이의 관계 |
덤프를 보존하고 확인된 정보를 기록하세요
펌웨어 분석을 위해 원본 이미지는 그대로 보관하고 작업용 복사본을 분석하세요. 출처, 날짜, 크기, SHA-256 해시를 기록하면 나중에 같은 바이트를 가리키는지 확인할 수 있습니다. 해시는 펌웨어의 안전성이나 분석 권한을 증명하지 않습니다.
가져오기 전에 장치 모델과 리비전, 칩 계열, 명령어 집합, 바이트 순서, 플래시 시작점, 알려진 부트 진입점, 분할 이미지 오프셋처럼 근거가 있는 정보를 모으세요. 보드 설명서, 링커 맵, 빌드 설정, 제조사 문서, 소스 코드를 우선하고 모르는 값은 명확히 표시하세요.
소유했거나 분석 허가를 받은 펌웨어와 하드웨어만 조사하세요. 이 가이드는 기술 정보이며 법률 자문이나 리버스 엔지니어링 허가가 아닙니다.
- 원본을 읽기 전용으로 보관하고 SHA-256 해시를 기록합니다.
- 파일 오프셋, 물리 주소, 가상 주소를 별도로 적습니다.
- 아키텍처나 주소를 선택한 근거와 신뢰도를 남깁니다.
- 불확실한 설정은 버려도 되는 프로젝트에서 시험합니다.
디스어셈블을 신뢰하기 전에 프로세서 언어를 선택하세요
Ghidra의 프로세서 언어는 명령어 해석과 레지스터를 정의합니다. 장치 근거를 바탕으로 프로세서 계열, 명령어 집합 변형, 주소 폭, 엔디언을 선택하세요. 이름이 비슷해도 모드나 데이터 배치가 다를 수 있습니다. 그럴듯한 니모닉이 표시된다는 사실은 선택을 검증하지 않습니다.
컴파일러 사양은 호출 규약과 자료형을 정하는 별도 설정이며, ABI를 모르는 Raw 이미지에서는 임시 선택일 수 있습니다. ARM과 Thumb처럼 모드가 달라지는 지점은 부트 코드나 문서로 확인하고 모든 주소에 한 모드를 강제로 적용하지 마세요.
- 1
프로세서 계열 확인
파일 이름만 보지 말고 장치 문서에 적힌 칩이나 코어를 확인합니다.
- 2
모드와 엔디언 확인
빌드 산출물, 부트 코드, 설정, 알려진 명령어 바이트를 서로 대조합니다.
- 3
불확실성 유지
가능한 변형을 별도의 프로그램 복사본에서 시험하고 검증된 영역을 비교합니다.
Ghidra에서 Raw 펌웨어 이미지 가져오기
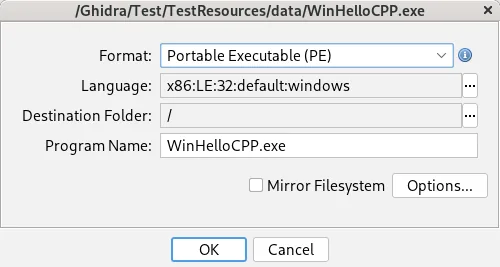
신뢰할 수 있는 Ghidra 펌웨어 분석 절차는 새 프로젝트를 만들고 알려진 실행 컨테이너가 없는 덤프를 Raw Binary로 가져오는 단계부터 시작합니다. 근거로 확인한 프로세서 언어를 선택하세요. 문서나 빌드 산출물이 뒷받침할 때만 로드 주소를 입력합니다.
설정이 불확실하다면 작업용 복사본에서 Auto Analysis를 미루고 언어와 주소를 먼저 확인하세요. 가정이 뒷받침된 뒤 분석을 실행하고 원본 해시를 프로젝트 메모에 남깁니다.
파일 오프셋과 대상 주소를 구분하세요
파일 오프셋은 덤프 안의 위치이고 대상 주소는 장치가 바이트를 배치하는 곳입니다. 연속 이미지라면 대상 주소 = 확인된 기준 주소 + 파일 오프셋입니다. 이 식만으로 기준 주소, 이미지의 연속성, 진입점을 증명할 수는 없습니다.
기준 주소 근거와 리셋 또는 진입 주소를 따로 기록하세요. 부트로더가 ROM 바이트를 RAM 주소로 복사하거나 이미지가 미러링·뱅킹될 수 있습니다. 다른 보드의 주소를 그대로 쓰거나 ROMBASEADDR을 보편적인 Ghidra 이미지 기준 주소로 간주하지 마세요.
파일 오프셋, 메모리 로드 주소, 실행 진입점은 서로 다를 수 있습니다. 각각 별도 항목으로 기록하고 근거도 남기세요.
target_address = verified_base_address + file_offset존재하지 않는 영역을 만들지 않고 메모리 맵 구성하기
펌웨어 분석을 진행할 때 Memory Map으로 파일에 대응하는 범위와 실행 중에만 존재하는 메모리를 나눕니다. 각 블록의 시작, 길이, 권한, 연결 파일을 확인하세요. 근거가 있으면 플래시를 읽기 전용으로 지정하고 RAM과 메모리 매핑 주변 장치는 문서로 확인한 범위만 추가합니다.
분할되거나 복사된 코드는 근거가 있는 대상 위치에 매핑하고 원본 오프셋을 기록하세요. 초기화되지 않은 RAM, 주변 장치 레지스터, 미러, 예약 영역은 구분해야 합니다. 근거 없이 실행 블록을 만들면 잘못된 참조와 함수가 생깁니다.
| 영역 유형 | 기록할 항목 | 흔한 실수 |
|---|---|---|
| 파일에 연결된 플래시 또는 ROM | 입력 파일, 오프셋, 대상 주소, 권한 | 파일의 첫 바이트를 보편적인 주소로 간주 |
| 초기화되지 않은 RAM | 근거가 있는 범위와 읽기·쓰기·실행 권한 | 0으로 채운 뒤 파일 내용인 것처럼 분석 |
| 메모리 매핑 I/O | 문서에 나온 주변 장치 범위와 동작 | 모든 참조를 일반 프로그램 데이터로 취급 |
| 복사되거나 나뉜 영역 | 원본 오프셋, 대상 주소, 길이, 근거 | 실행 대상이 아니라 원본 위치에 매핑 |
단계적으로 분석하고 부트 경로 검증하기
언어와 메모리 블록에 근거가 있으면 작고 의미 있는 범위부터 분석하세요. 명령어를 프로세서 설명서와 대조하고 분기 대상이 매핑된 코드에 도달하는지 확인합니다. Cortex-M 벡터 테이블은 초기 스택 값과 리셋 핸들러를 알려 줄 수 있지만 다른 형식은 다르므로 장치 자료를 확인해야 합니다.
초기 코드가 일관되면 분석 범위를 넓히세요. 경고, 참조, 함수 경계, 문자열, 데이터 접근을 검토합니다. 부트 이미지와 애플리케이션 이미지를 구분하고 각 실험을 정돈된 프로젝트로 보존하세요.
Listing, 참조, Decompiler에서 분석 결과 확인하기
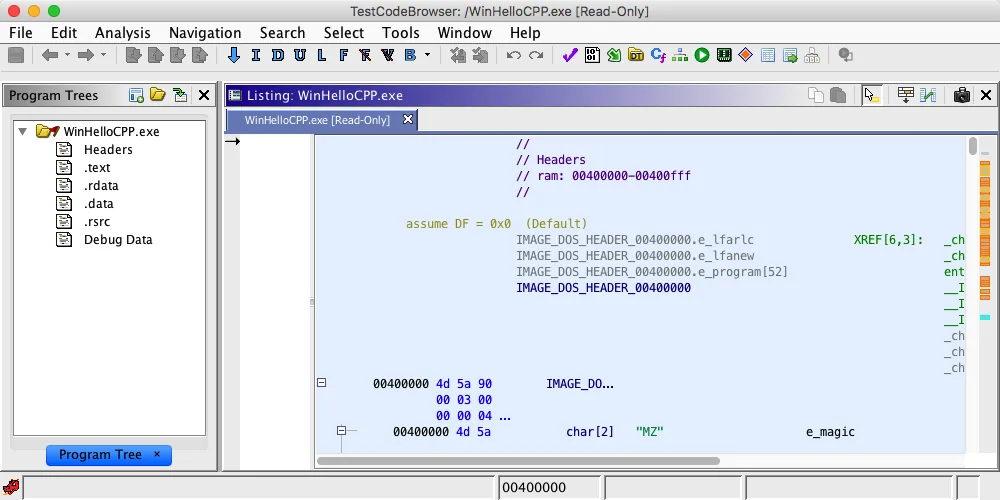
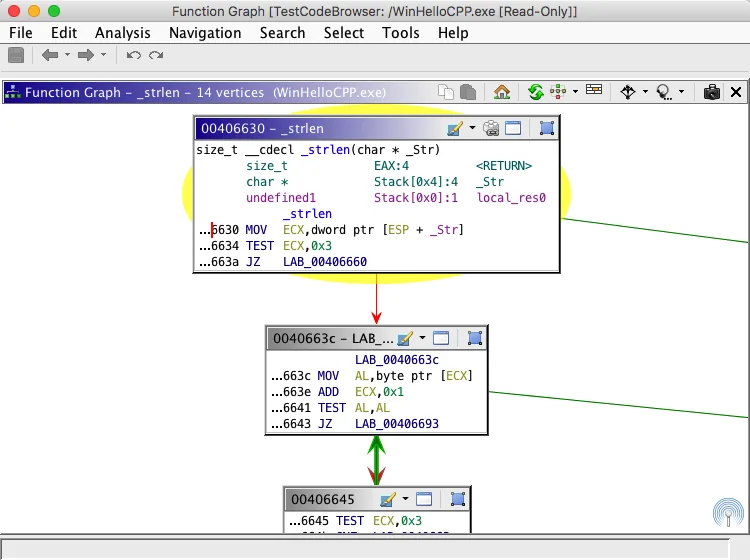
문자열과 상수는 단서로만 보세요. 참조를 따라가고 Listing에서 바이트와 명령어 경계를 확인한 뒤 Function Graph에서 흐름을 비교합니다. Decompiler로 읽기 쉬운 가설을 세울 수 있지만 중요한 결론은 명령어와 메모리 접근으로 검증해야 합니다.
그럴듯한 함수도 잘못된 주소나 모드에 기반할 수 있습니다. 호출자, 분기 대상, 영역 간 참조를 다시 확인하세요. Decompiler 가이드는 의사 코드의 한계를, 검색 가이드는 문자열·주소·XREF 찾기를 설명합니다.
Ghidra 펌웨어 분석에서 자주 생기는 문제 해결
Ghidra 펌웨어 분석 결과가 이상하면 이름을 바꾸기 전에 전제를 확인하세요. 파일 해시, 언어, 엔디언, 기준 주소, 매핑 범위, 실행 권한, 명령어 모드를 점검합니다.
프로젝트 복사본, 바꾼 설정, 근거, 결과를 기록하세요. 실제 수정과 해석이 우연히 달라진 경우를 구분하기 쉽습니다.
| 증상 | 먼저 확인할 항목 | 다음 단계 |
|---|---|---|
| 의미 없는 명령어 | 프로세서 변형, 엔디언, 모드 | 알려진 여러 바이트를 장치 문서와 대조 |
| 분기가 매핑 범위를 벗어남 | 기준 주소, 오프셋, 복사 영역 | 원본과 대상 근거를 바탕으로 맵 재구성 |
| Decompiler에 정의되지 않은 값이 많음 | 언어, 함수 경계, 메모리 매핑 | 바이트를 검증하고 근거 있는 경계만 정의 |
| 의심스러운 함수가 너무 많음 | 데이터, 패딩, 주변 장치가 코드로 분석됐는지 | 실행 범위를 줄이고 통제된 분석을 다시 실행 |
| 문자열이나 포인터가 어긋나 보임 | 워드 폭, 엔디언, 정렬 | Raw 바이트와 Listing 참조를 비교 |
이 절차만으로 확인할 수 없는 내용
Ghidra 펌웨어 분석 작업은 이미지를 디코딩하고 정리할 수 있지만 모든 제조사 컨테이너를 풀거나 하드웨어를 에뮬레이션하거나 코드의 안전성을 증명하거나 주변 장치를 모두 식별하지는 않습니다. 추출, 서명 검증, 취약점 평가는 별도 작업입니다. 의사 코드가 그럴듯해도 실제 동작을 단정하지 말고 근거와 한계를 기록하세요.
공식 인터페이스와 프로젝트 자료는 GhidraDocs에서 확인하세요. ARM Cortex-M 예제와 Magic Lantern 메모리 맵 예제는 각 자료에 명시된 장치에만 적용됩니다.
- 프로젝트 생성과 Auto Analysis를 보려면 Ghidra 입문 가이드를 확인하세요.
- 일괄 분석과 보고서 생성에는 Headless Analyzer 가이드를 사용하세요.
- 공식 릴리스 확인, JDK 준비, 첫 실행은 설치 가이드에서 살펴보세요.
Ghidra 펌웨어 분석에 관한 질문
Ghidra가 Raw 펌웨어 바이너리를 분석할 수 있나요?
가능합니다. Raw Binary로 가져오고 근거가 있는 프로세서 언어를 선택한 다음 정당화할 수 있는 주소 범위를 정의하세요. Raw 가져오기만으로 아키텍처나 메모리 배치를 알 수는 없습니다.
펌웨어의 올바른 기준 주소는 어떻게 찾나요?
데이터시트, 링커 맵, SDK, 부트로더, 문서화된 이미지 형식을 확인하세요. 파일 이름이나 다른 장치에서 추측하지 말고 리셋 진입점과도 구분해야 합니다.
Raw 펌웨어를 가져오자마자 Auto Analysis를 실행해야 하나요?
언어나 주소 맵이 불확실하면 먼저 설정을 확인하고 작업용 복사본에서 분석을 미루는 편이 좋습니다. 전제가 뒷받침된 뒤 통제된 분석을 실행하고 경고를 검토하세요.
Ghidra에서 의미 없는 명령어가 나오는 이유는 무엇인가요?
프로세서나 모드, 엔디언, 기준 주소, 메모리 배치가 틀렸을 수 있습니다. 분석 범위를 늘리기 전에 명령어 바이트를 장치 문서와 대조하세요.
다른 장치용 튜토리얼의 주소를 써도 되나요?
검증 없이 사용하면 안 됩니다. 메모리 구조는 모델, 리비전, 부트로더, 이미지에 따라 다릅니다. 튜토리얼은 방법의 예로만 참고하고 분석 대상 장치의 근거에서 주소를 도출하세요.
Ghidra가 펌웨어가 안전하다는 것을 증명하나요?
아닙니다. 정적 분석은 바이트와 명령어를 이해하는 데 도움을 주지만 하드웨어 동작이나 안전성을 보증하지 않습니다. 서명 검증, 테스트, 취약점 평가는 별도로 진행해야 합니다.