
Ghidraのファームウェア解析は実行ファイル解析と何が違う?
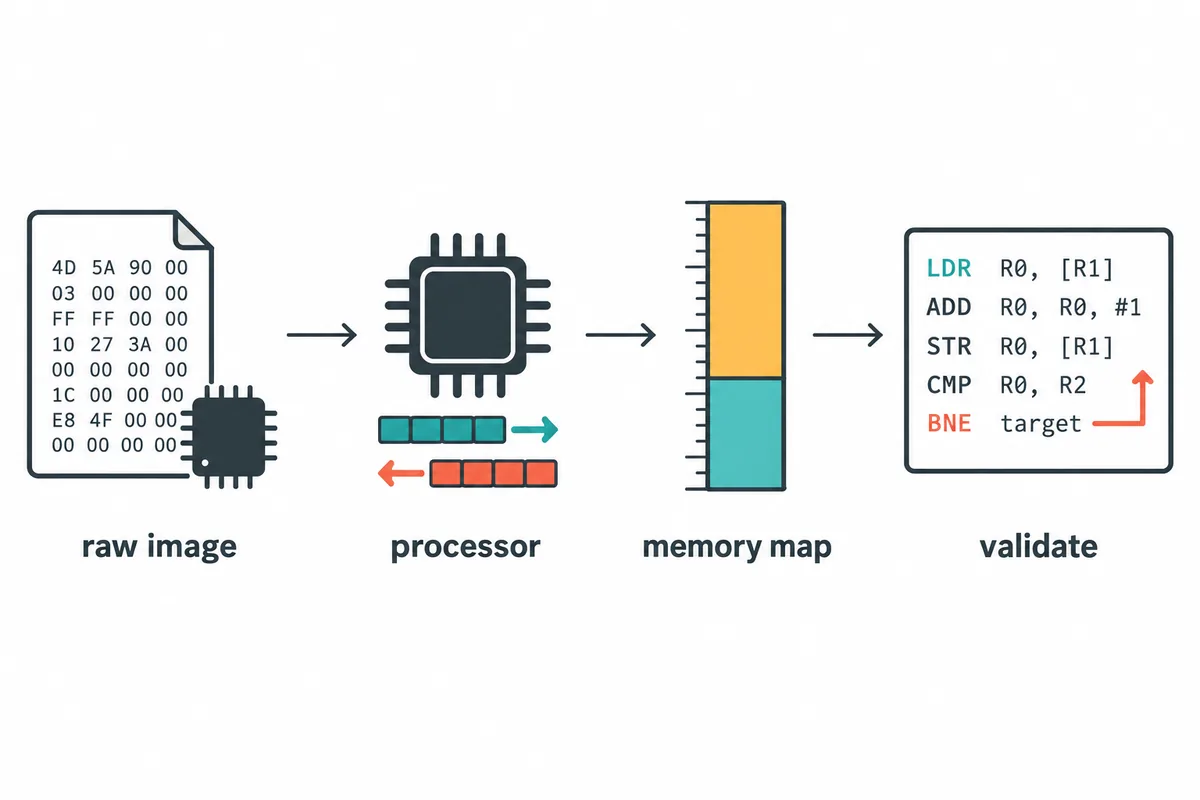
PEやELFの実行ファイルには、セクション、マシン種別、ロード情報を示すヘッダーがあります。一方、Rawファームウェアは単なるバイト列で、ブートローダー、アプリケーション、定数、パディング、RAMへコピーされるデータが混在していても、プロセッサ、バイト順、実行時アドレスが記録されていない場合があります。
Ghidraは不足したデバイス情報を推測できません。言語やベースアドレスを誤ると、もっともらしい命令や誤った参照が表示されることがあります。ファームウェア解析では、データシート、リンカーマップ、SDK、ブートローダーのソースなど、信頼できる根拠で設定を照合してください。
| 入力 | Ghidraが推測できること | 確認が必要なこと |
|---|---|---|
| PEまたはELF | コンテナ形式と多くの場合のマシン種別 | 特殊なセクション、独自ローダー、実行時の動作 |
| Rawファームウェア | バイト列と一部のパターン | プロセッサ言語、エンディアン、ロード先、メモリ領域 |
| 複数の抽出ファイル | 各ファイルを個別のバイト範囲として扱うこと | 各断片とデバイス上のアドレスとの対応 |
ダンプを保全し、判明している情報を書き留める
元のイメージは変更せずに保管し、作業用コピーを解析します。取得元、日付、サイズ、SHA-256ハッシュを記録すれば、後のメモが同じバイト列を指しているか確認できます。ただし、ハッシュは安全性や解析許可を証明するものではありません。
取り込み前に、機器の型番とリビジョン、チップ系列、命令セット、バイト順、フラッシュの起点、既知の起動位置、分割イメージのオフセットなど、裏付けのある情報を集めます。基板資料、リンカーマップ、ビルド設定、メーカー文書、ソースコードを優先し、不明な値は不明として記録してください。
自分が所有する、または調査の許可を得たファームウェアと機器だけを解析してください。このガイドは技術情報であり、法律相談やリバースエンジニアリングの許可ではありません。
- 元ファイルを読み取り専用で保管し、SHA-256を記録する。
- ファイルオフセット、物理アドレス、仮想アドレスを分けて記録する。
- アーキテクチャやアドレスの根拠と確度を残す。
- 不確かな設定を試すときは使い捨てのプロジェクトを使う。
逆アセンブルを信頼する前にプロセッサ言語を選ぶ
Ghidraのプロセッサ言語は命令のデコードとレジスタを定義します。デバイスの根拠に基づき、プロセッサ系列、命令セットの変種、アドレス幅、エンディアンを選んでください。似た名前でも命令モードやデータ配置が異なります。もっともらしいニーモニックが表示されても、選択の検証にはなりません。
コンパイラー仕様は引数の場所や型などの規約を決める別の設定です。ABIが分からないRawイメージでは暫定値になることがあります。ARMとThumbのように複数モードがある場合は、起動コードや文書から適用範囲を特定し、全アドレスに一つのモードを強制しないでください。
- 1
プロセッサ系列を特定する
ファイル名ではなく、機器資料に記載されたチップやコアを確認します。
- 2
モードとエンディアンを確認する
ビルド成果物、起動コード、設定、既知の命令バイトを照合します。
- 3
不確実性を残す
候補を別々のプログラムコピーで試し、検証済み領域を比較します。
RawファームウェアイメージをGhidraに取り込む
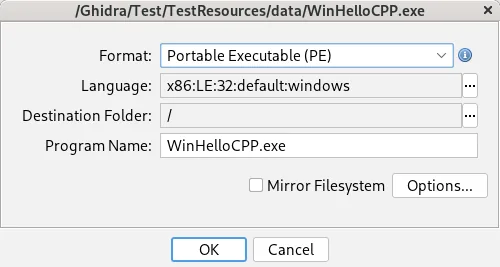
信頼できるGhidraファームウェア解析では、認識可能な実行形式を持たないダンプを新しいプロジェクトにRaw Binaryとして取り込みます。根拠に基づくプロセッサ言語を選び、ロードアドレスは文書やビルド成果物で確認できる場合だけ入力してください。根拠がなければ未確定のままにします。
設定に確信が持てない場合は、作業用コピーでAuto Analysisを保留し、言語とアドレスを確認します。前提が裏付けられたら解析を実行し、元イメージのハッシュをプロジェクトメモに残してください。
ファイルオフセットと実行先アドレスを区別する
ファイルオフセットはダンプ内の位置で、実行先アドレスはデバイスがそのバイトを配置する場所です。連続したイメージなら、実行先アドレス = 確認済みのベースアドレス + ファイルオフセットという関係になります。この式だけでは、ベース、連続性、エントリーポイントは分かりません。
ベースアドレスの根拠はリセットまたはエントリー位置と分けて記録します。ブートローダーがROMからRAMへコードをコピーする場合や、ミラー領域・バンクがある場合もあります。別の基板の値やROMBASEADDRという名前を、そのまま共通アドレスとして使わないでください。
ファイルオフセット、メモリへのロード先、実行開始位置は異なることがあります。別々に記録し、それぞれの根拠を残してください。
target_address = verified_base_address + file_offset存在しない領域を作らずにメモリマップを組む
Ghidraのファームウェア解析では、Memory Mapを使ってファイルに対応する範囲と実行時だけ存在するメモリを分けます。各ブロックの開始、長さ、権限、対応ファイルを確認してください。資料で裏付けられる場合はフラッシュを読み取り専用にし、RAMやメモリマップドI/Oは根拠のある範囲だけ追加します。
分割された領域やROMからコピーされるコードは、根拠のある配置先に割り当て、元オフセットを記録します。未初期化RAM、周辺レジスタ、ミラー、予約領域を区別してください。実行可能ブロックを推測で作ると、誤った参照や関数が生まれます。
| 領域の種類 | 記録する内容 | よくある誤り |
|---|---|---|
| ファイル対応のFlashまたはROM | 入力ファイル、オフセット、配置先、権限 | ファイル先頭を共通アドレスとみなす |
| 未初期化RAM | 根拠のある範囲と読み書き・実行権限 | ゼロで埋めてファイル由来のコードとして解析する |
| メモリマップドI/O | 資料にある周辺領域とアクセス動作 | 参照を通常のプログラムデータとみなす |
| コピーまたは分割領域 | 元オフセット、配置先、長さ、根拠 | 実行先ではなくコピー元に割り当てる |
段階的に解析し、起動経路を検証する
言語とメモリ領域を根拠で説明できたら、小さく意味のある範囲から解析します。命令をプロセッサ資料と照合し、分岐先がマップ済みコードにあるか確認してください。Cortex-Mではベクターテーブルから初期スタック値やリセットハンドラーを推定できる場合がありますが、形式は機器により異なります。
初期コードに整合性があれば解析範囲を広げます。警告、参照、関数境界、文字列、データアクセスを確認してください。ブートとアプリのイメージは区別し、各実験を整理したプロジェクトに保存します。
Listing、参照、Decompilerで結果を検証する
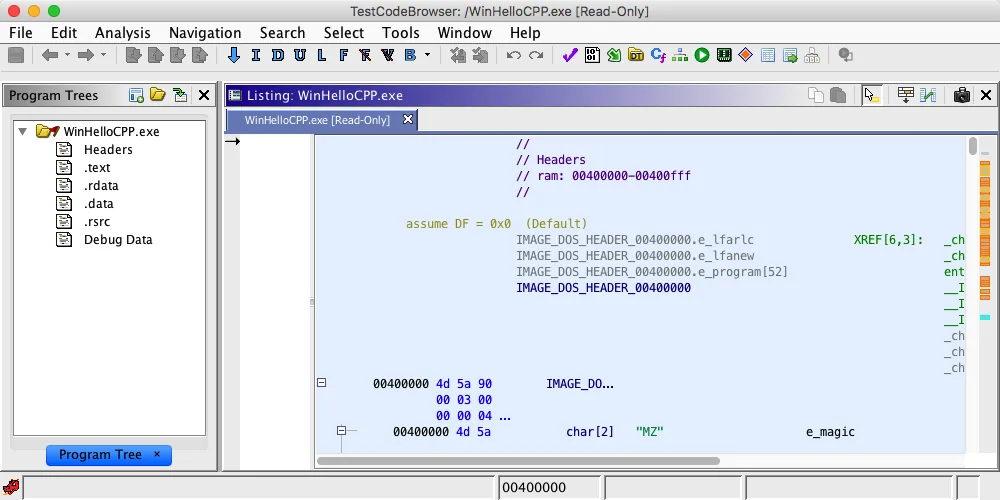
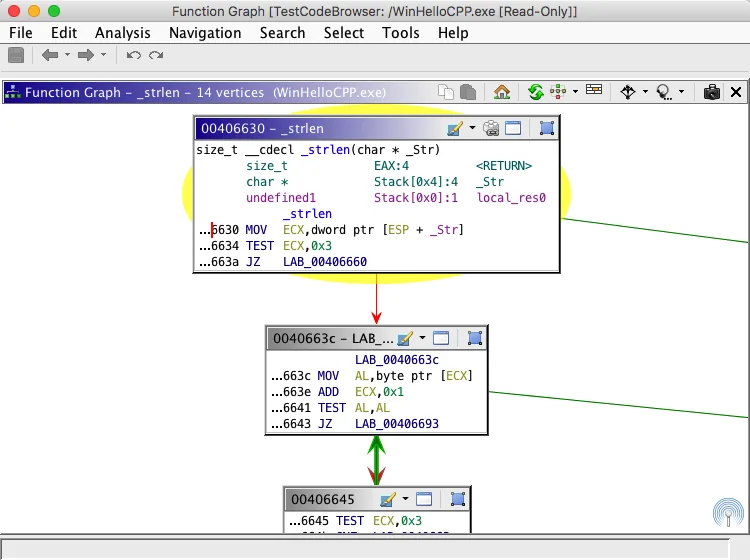
文字列や定数は手掛かりとして扱います。参照をたどり、Listingでバイトと命令境界を確認してから、Function Graphで制御フローを比べます。Decompilerは読みやすい仮説を作る助けになりますが、重要な結論は命令やメモリアクセスで確かめてください。
もっともらしい関数でも、アドレスやモードが間違っている可能性があります。呼び出し元、分岐先、領域をまたぐ参照を再確認してください。Decompilerガイドでは疑似コードの読み方を、検索ガイドでは文字列、アドレス、XREFの探し方を説明しています。
Ghidraでのファームウェア解析で起きる問題を調べる
解析結果がおかしいときは、名前を変える前に前提を見直します。ファイルハッシュ、言語、エンディアン、ベースアドレス、マップ範囲、実行権限、命令モードを確認してください。
プロジェクトのコピー、変更した設定、根拠、結果を記録してください。解釈の偶然の変化と、本当の修正を区別できます。
| 症状 | 最初に確認すること | 次の手順 |
|---|---|---|
| 意味のない命令が表示される | プロセッサ変種、エンディアン、モード | 既知の複数バイトをデバイス資料と照合する |
| 分岐がマップ範囲外へ進む | ベース、オフセット、コピー領域 | 元と配置先の根拠からマップを作り直す |
| Decompilerに未定義が多い | 言語、関数境界、メモリ配置 | 命令バイトを確かめ、根拠のある境界だけ定義する |
| 不自然な関数が多く見つかる | データ、パディング、周辺領域の誤解析 | 実行範囲を絞り、管理された解析をやり直す |
| 文字列やポインターがずれて見える | ワード幅、エンディアン、アラインメント | RawバイトとListingの参照を比較する |
この手順だけでは分からないこと
Ghidraのファームウェア解析はイメージのデコードや整理に役立ちますが、すべてのメーカー形式を展開したり、実機をエミュレートしたり、安全性や周辺機器を証明したりはしません。抽出、署名検証、脆弱性評価は別の作業です。疑似コードがもっともらしく見えても、実際の動作を断定せず、根拠と限界を記録してください。
公式の仕様や画面についてはGhidraDocsを参照してください。ARM Cortex-Mの例とMagic Lanternのメモリマップ例は、各資料に記載された機器に限って適用できます。
- プロジェクト作成からAuto Analysisまでを確認するにはGhidra入門ガイドを参照します。
- バッチ解析やレポート生成にはHeadless Analyzerガイドを使います。
- 公式版の確認、JDKの準備、初回起動にはインストールガイドを参照します。
Ghidraのファームウェア解析に関する質問
GhidraでRawファームウェアを解析できますか?
できます。Raw Binaryとして取り込み、根拠のあるプロセッサ言語を選び、説明できるアドレス範囲を定義します。Rawで取り込むだけでは、アーキテクチャやメモリ配置は分かりません。
正しいファームウェアのベースアドレスはどう調べますか?
データシート、リンカーマップ、SDK、ブートローダー、文書化されたイメージ形式を確認します。ファイル名や別の機器から推測せず、実行開始位置とも区別してください。
Rawファームウェアの取り込み直後にAuto Analysisを実行すべきですか?
言語やアドレスマップが不確かな場合は、まず設定を確認し、作業用コピーで解析を保留する方法があります。前提が裏付けられた後に解析を実行し、警告を確認してください。
Ghidraで意味のない命令が表示されるのはなぜですか?
プロセッサや命令モード、エンディアン、ベースアドレス、メモリ配置が誤っている可能性があります。解析範囲を広げる前に、命令バイトを機器資料と照合してください。
他の機器向けチュートリアルのアドレスを使えますか?
検証せずに使うことはできません。メモリ配置は機種、リビジョン、ブートローダー、イメージによって異なります。チュートリアルは手順の参考にとどめ、対象機器の根拠からアドレスを導いてください。
Ghidraはファームウェアの安全性を証明しますか?
証明しません。静的解析はバイトや命令の理解に役立ちますが、実機の動作や安全性を保証しません。署名検証、テスト、脆弱性評価には別の手順が必要です。