
Qué significan los tipos de datos de Ghidra
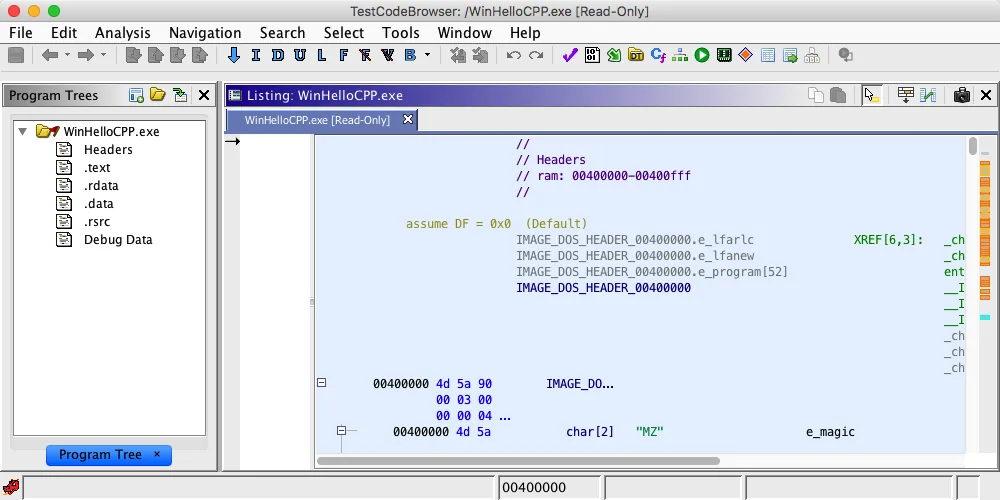
Los tipos de datos de Ghidra describen cómo debe leerse un rango de bytes. Un programa recién importado contiene bytes indefinidos, a menudo mostrados como signos de interrogación, hasta que el análisis o el analista aplica un tipo. Aplicarlo no reescribe el archivo original: añade una interpretación al modelo del programa. Un byte puede ser un entero con signo, un puntero, una cadena, un campo de estructura, un elemento de matriz u otro tipo compatible.
La frontera importante está entre evidencia e interpretación. Los bytes, la dirección, el lenguaje del procesador, el orden de bytes, las referencias y los accesos repetidos son evidencia. Un nombre como `header`, `count` o `next` es una interpretación que debe apoyarse en esos hechos. Un buen flujo de tipos de datos de Ghidra registra por qué se eligió un tipo, comprueba su tamaño y alineación, y conserva una copia del proyecto cuando cambia la hipótesis. Varios tipos pueden explicar los mismos bytes, por eso importa el rastro de evidencia.
Esta página se centra en el modelado dentro de CodeBrowser. La guía de Ghidra Decompiler explica cómo unos tipos mejores hacen más legible el pseudocódigo, mientras que la guía de búsqueda de Ghidra ayuda a encontrar primero la dirección o cadena que debe modelarse.
Usa el tipo que explique los bytes y el patrón de acceso con menos supuestos sin respaldo. Si las referencias posteriores no coinciden, deshazlo o sustitúyelo en vez de obligar al decompilador a parecer limpio.
| Concepto | Qué indica | Qué verificar |
|---|---|---|
| Dato indefinido | Los bytes no tienen una interpretación comprometida | Dirección, bloque, codificación y referencias cercanas |
| Tipo primitivo | Tamaño y representación de valor conocidos | Lenguaje, signo, orden de bytes y alineación |
| Estructura | Campos con nombre en desplazamientos explícitos | Orden, relleno, tamaño y accesos repetidos |
| Puntero | Un valor interpretado como dirección | Espacio de direcciones, tipo destino y referencias válidas |
| Matriz | Elementos repetidos con paso fijo | Tipo de elemento, cantidad y rango total de bytes |
Abre Data Type Manager y elige una categoría de tipos de datos de Ghidra
Abre el programa en CodeBrowser y lleva al frente la ventana Data Type Manager desde el menú Window. La posición exacta depende del espacio de trabajo, pero normalmente el gestor separa tipos integrados, tipos del programa actual y tipos cargados desde archivos. Localiza primero la categoría del programa y la familia que necesitas; importar un archivo grande puede ocultar el pequeño conjunto relevante para la muestra.
Los tipos integrados sirven para valores primitivos y cadenas comunes. Los tipos del programa son el lugar más seguro para una estructura que aún pruebas porque viajan con el proyecto. Los archivos pueden aportar definiciones conocidas de plataforma o biblioteca, pero coincidir en el nombre no demuestra que el objetivo use el mismo ABI, empaquetado o versión. Anota el origen y la confianza de cada tipo importado y compara candidatos antes de confirmarlo.
Antes de cambiar una dirección seleccionada, apunta la dirección, la vista actual y cuántos bytes esperas consumir. Esta línea base hace visible un sobrescrito accidental y permite comparar Listing antes y después.
- 1
Selecciona programa y dirección
Abre un binario de práctica o una muestra autorizada, elige una dirección en Listing y confirma el programa y bloque de memoria activos.
Program -> CodeBrowser -> Listing - 2
Muestra el gestor
Elige Window > Data Type Manager y expande las categorías sin importar un archivo innecesario.
Window -> Data Type Manager - 3
Elige la fuente más estrecha
Usa un tipo integrado para un primitivo, uno del programa para una estructura cambiante y un archivo solo con ABI compatible.
BuiltIn / Program / Archive - 4
Registra la línea base
Anota dirección, bytes actuales, nombre del bloque, lenguaje y tamaño esperado antes de aplicar un tipo.
address + bytes + expected size
Aplica tipos de datos de Ghidra primitivos sin perder el contexto de bytes
Los tipos primitivos son el inicio más seguro cuando la evidencia es un ancho o una codificación conocida. Un byte, word, dword, qword, carácter, booleano, float o puntero cambia cómo Listing muestra los mismos bytes sin modificar el archivo en disco. Selecciona el rango correcto, elige el comando de datos o arrastra un tipo desde Data Type Manager y revisa de inmediato el tamaño resultante. Conserva tipos alternativos en tus notas cuando la evidencia siga siendo ambigua.
No supongas que un entero tiene el mismo ancho en todos los lenguajes de procesador. La especificación del lenguaje y del compilador determina el tamaño y la representación de muchos tipos integrados. El signo cambia la interpretación del bit alto y el orden de bytes cambia cómo varios bytes forman un valor. Si el valor se usa como dirección, prueba un puntero solo después de confirmar el espacio de direcciones y las referencias cercanas.
Cuando una definición consume bytes que deberían quedar separados, deshaz la acción y reduce la selección. Un comando correcto no equivale a un modelo correcto. Registra los bytes originales y la dirección final esperada para detectar un rango desplazado o un hueco de alineación.
- Comprueba el lenguaje del procesador y el tamaño de dirección antes de elegir un tipo de varios bytes.
- Usa el ancho de acceso observado y los operandos de instrucciones como evidencia para signo y tamaño.
- Trata un puntero como hipótesis de dirección y verifica su destino en el espacio de memoria activo.
- Aplica una definición cada vez mientras aprendes un binario para poder deshacer un rango incorrecto.
- Anota los bytes indefinidos que queden entre campos conocidos; pueden ser relleno o un campo perdido.
address: 0x00402010 | size: 4 | observed: little-endian load | type: uint32_t | confidence: mediumbytes -> type -> Listing check -> reference check -> Decompiler checkCrea y aplica una estructura con tipos de datos de Ghidra
Crea una estructura cuando varios campos se leen en desplazamientos estables desde la misma base. Una estructura no es solo una lista de conjeturas: define orden, desplazamientos, tamaños y normalmente una longitud total. Empieza con el conjunto mínimo respaldado por cargas y almacenamientos repetidos. Puedes añadir nombres y tipos después, pero cambiar el tamaño de un campo puede mover todos los siguientes y alterar la interpretación de los llamadores.
En Data Type Manager crea una estructura nueva en la categoría del programa, dale un nombre temporal descriptivo y añade campos por desplazamiento. Usa relleno explícito solo cuando lo apoyen la alineación o los accesos observados. Si un campo es un puntero, aplica el destino más defendible, no una estructura elegida porque su nombre parece familiar. Un nodo autorreferente puede apuntar a su propia estructura, pero verifica que el binario siga realmente el puntero.
Cuando esté definida, aplícala en la dirección base de Listing. Comprueba cada límite y compara el tamaño total con el siguiente objeto o instancia repetida. Dos instancias con un paso constante son evidencia útil de una matriz de estructuras. Si el objeto siguiente empieza en un desplazamiento inesperado, conserva visible el hueco hasta saber si es relleno, unión, otra versión o un tipo erróneo.
- 1
Crea una estructura del programa
En Data Type Manager elige la categoría del programa, crea una estructura y usa un nombre temporal que describa la evidencia, no un significado inventado.
Program Types -> New -> Structure - 2
Añade campos por desplazamiento
Añade campos primitivos, matrices, enumeraciones o punteros conocidos. Deja bytes desconocidos como indefinidos o relleno explícito hasta tener una referencia.
offset 0x00 -> field_0; offset 0x04 -> field_4 - 3
Aplica en la base
Selecciona la base en Listing, aplica la estructura y verifica que cada campo termine donde lo espera el siguiente acceso.
Listing -> Data -> apply structure - 4
Compara instancias repetidas
Busca el mismo patrón o paso en otra dirección antes de renombrar la estructura como objeto confirmado.
base + stride -> second instance
| Decisión de estructura | Evidencia útil | Riesgo si se adivina |
|---|---|---|
| Tamaño de campo | Ancho de carga/almacenamiento y desplazamiento repetido | Todos los campos siguientes se mueven |
| Relleno | Límite de alineación o hueco constante | Se oculta un campo real o la estructura crece demasiado |
| Destino del puntero | Desreferencia y referencias válidas al destino | Decompiler muestra un grafo de objetos engañoso |
| Longitud | Siguiente objeto, paso de matriz o tamaño de asignación | Matrices y llamadores dejan de coincidir |
Usa matrices, enumeraciones, typedefs y punteros en tipos de datos de Ghidra
Una matriz es adecuada cuando se repite el mismo tipo de elemento con un paso predecible. Define primero el elemento y fija la cantidad solo cuando la respalden un límite de bucle, una longitud de tabla, un objeto vecino o el tamaño de una asignación. Una cantidad inventada puede hacer que bytes ajenos parezcan elementos válidos. Para una cadena terminada en cero o un búfer de tamaño dinámico, deja explícito el límite en vez de forzar una matriz fija.
Las enumeraciones mejoran la lectura cuando un valor se compara con un conjunto pequeño y repetido de constantes. Nombra solo valores apoyados por comparaciones o documentación y conserva visible cualquier valor desconocido. Los typedefs dan un nombre estable a un primitivo o puntero repetido, pero no crean evidencia nueva. Son más útiles cuando el tipo subyacente y la convención de llamada ya están claros.
Los punteros requieren más disciplina porque solo tienen sentido dentro de un espacio de direcciones. Confirma si apuntan a una estructura, cadena, función o tabla y comprueba al menos una referencia real. Una cadena de punteros elegante en Decompiler puede ser errónea si la base, el segmento o el ancho son incorrectos. Deja anotados el destino y el supuesto de espacio de direcciones.
Es mejor mostrar un byte indefinido o un valor de enumeración desconocido que hacer parecer seguro todo el objeto. La incertidumbre visible se puede probar; un campo inventado no.
| Patrón | Úsalo cuando | Límite que registrar |
|---|---|---|
| Matriz | Los elementos repiten un paso conocido | Tipo de elemento y cantidad o regla de terminación |
| Enumeración | Un valor se compara con constantes con nombre | Valores conocidos y caso desconocido explícito |
| Typedef | Un tipo probado necesita un nombre reutilizable | Tipo subyacente y convención de llamada |
| Puntero | El valor se desreferencia o se usa como dirección | Espacio de direcciones y tipo destino |
| Puntero a función | Una tabla o llamada es indirecta | Prototipo, paso de tabla y evidencia de llamada |
Verifica los tipos de datos de Ghidra en Listing y Decompiler
Después de aplicar un tipo, vuelve a Listing e inspecciona bytes, dirección, desplazamientos y referencias exactos. Confirma que la definición permanezca dentro del bloque de memoria previsto y que los valores mostrados coincidan con las instrucciones de carga y almacenamiento. Si se solapa con una instrucción o cadena conocida, detente y deshazla. Listing es el registro a nivel de dirección y debe seguir siendo comprensible aunque Decompiler aún no se haya actualizado.
Después selecciona una función que lea el objeto tipado y abre Decompiler. Una firma, estructura o puntero mejor puede sustituir valores indefinidos y conversiones por nombres de campos, pero esa mejora es una comprobación de coherencia, no una prueba. Compara instrucciones decisivas con el pseudocódigo, incluido signo, aritmética de punteros, índices de matriz y valores devueltos. Si la salida cambia cuando termina el análisis, registra el cambio y revisa la evidencia original.
Revisa los tipos como un modelo conectado y no como etiquetas aisladas. Los tipos de Listing deben coincidir con la firma de la función, las desreferencias y los pasos de matriz. Si discrepan, conserva el tipo más sencillo respaldado por evidencia, marca el dudoso como provisional y prueba otra referencia antes de dar un nombre definitivo.
Usa la guía de Function Graph cuando un campo se lee en varias ramas y la guía de análisis de firmware cuando el mapa de direcciones sea incierto. Esas páginas responden preguntas cercanas; aquí el foco sigue siendo el modelo y sus límites.
Corrige tamaños, desplazamientos y vistas obsoletas de tipos de datos de Ghidra
Cuando un tipo parece incorrecto, empieza por la discrepancia más pequeña. Comprueba lenguaje del procesador, espacio de direcciones, orden de bytes, rango seleccionado y firma antes de cambiar varios campos. Un puntero de 64 bits aplicado a una tabla de 32, o una estructura empaquetada aplicada a datos alineados de forma natural, puede romper todos los accesos posteriores. Deshaz el último cambio, compara bytes y vuelve a probar un supuesto.
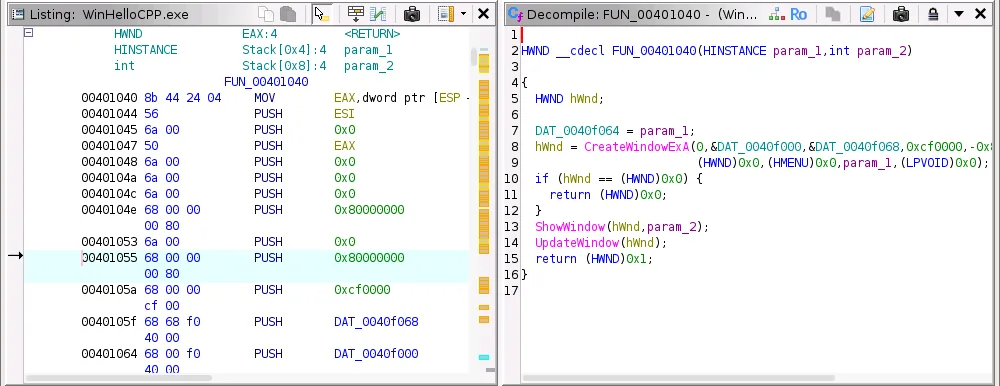
Una vista obsoleta de Decompiler también puede engañar. Espera a que termine el análisis, actualiza o vuelve a seleccionar la función y confirma que Listing y Decompiler apuntan a la misma dirección. Si un archivo aporta un nombre parecido, revisa tamaño y empaquetado subyacentes en vez de asumir compatibilidad. Conserva una copia del proyecto antes de cambios grandes para que el experimento sea reversible.
Anota dirección, tipo, lenguaje y cambio exactos que produjeron el problema. Una nota breve de antes y después ayuda más que adivinar repetidamente otra estructura.
| Síntoma | Comprobar primero | Siguiente acción segura |
|---|---|---|
| Los campos se desplazan | Tamaños, relleno y lenguaje | Deshacer, dejar el hueco indefinido y reconstruir |
| El puntero sale de memoria | Espacio, base y ancho | Tratarlo como entero hasta hallar un destino válido |
| Decompiler muestra muchas conversiones | Firma, signo y destino | Verificar un llamador y una carga en Listing |
| La matriz consume bytes ajenos | Cantidad, paso y terminación | Usar cantidad menor o límite dinámico |
| Falta un tipo en el gestor | Categoría, ruta y filtro | Actualizar e importar solo un archivo verificado |
Un flujo repetible para tipos de datos de Ghidra
Una sesión fiable de modelado es pequeña, explícita y fácil de revisar. Empieza con una pista: desplazamiento repetido, longitud conocida, desreferencia o comparación constante. Registra dirección y bytes, selecciona el tipo más estrecho que explique la pista y verifica el resultado en Listing antes de añadir nombres. Solo después pasa a una estructura, matriz, enumeración o puntero que combine varias observaciones respaldadas.
Para un equipo o una investigación repetida, conserva la versión del proyecto, el lenguaje del procesador, la fuente del tipo y la confianza de cada definición importante. Separa tipos del programa de importaciones especulativas y vuelve a comparar cuando un llamador discrepe. Usa la guía de Script Manager solo después de entender la operación manual. Un script puede aplicar un buen modelo de forma consistente, pero también propagar rápidamente un supuesto malo.
El objetivo no es que cada línea parezca código fuente. Es construir un modelo que explique bytes, referencias y flujo de control mientras muestra lo que sigue siendo desconocido. Mantén revisables los tipos, desplazamientos y destinos de puntero para que el siguiente analista pueda probar, corregir o automatizar la interpretación.
- 1
Ancla
Empieza con una dirección, referencia, límite de bucle o acceso repetido visible en Listing.
evidence -> address - 2
Modela
Aplica el tipo primitivo o de campo más pequeño que explique ancho y representación.
address -> type - 3
Comprueba
Compara bytes, desplazamientos, referencias y un consumidor de Decompiler antes de añadir nombres o relleno.
Listing -> Decompiler - 4
Preserva
Guarda una copia y registra motivo, confianza y camino de reversión del modelo.
type + evidence + rollback
- Usa binarios autorizados y conserva intactos los archivos originales.
- Separa en las notas los desplazamientos de archivo, direcciones cargadas y destinos de puntero.
- Prefiere incertidumbre visible a un campo o cantidad que solo sea una conjetura.
- Vuelve a comprobar los llamadores después de cambiar una estructura o firma.
- Automatiza solo después de que un ejemplo manual sea correcto y repetible.
Preguntas sobre tipos de datos de Ghidra
¿Para qué se usan los tipos de datos de Ghidra?
Los tipos de datos de Ghidra describen cómo mostrar e interpretar bytes en el modelo de un programa. Permiten definir primitivos, cadenas, estructuras, matrices, enumeraciones y punteros, y comprobarlos en Listing y Decompiler.
¿Cómo creo una estructura en Ghidra?
Abre Data Type Manager, crea una estructura en la categoría del programa actual, añade campos por desplazamiento, deja huecos sin definir o como relleno justificado y aplícala en su dirección base de Listing.
¿Por qué los campos de mi estructura tienen desplazamientos incorrectos?
Comprueba lenguaje del procesador, tamaños, alineación, empaquetado y relleno explícito. Deshaz la definición, compara los bytes originales y reconstruye la estructura mínima apoyada por accesos repetidos.
¿Debo definir un tipo de puntero en Ghidra?
Define un puntero cuando el valor se use como dirección y exista al menos una referencia que respalde el espacio y el destino. Sin esa evidencia, conserva un entero o un tipo conservador hasta verificar el destino.
¿Puede un tipo de datos de Ghidra cambiar el binario original?
Aplicar un tipo cambia el modelo del proyecto y sus vistas, no el archivo de entrada original. Conserva una copia del proyecto y notas al realizar cambios de modelado grandes.
¿Por qué Decompiler sigue mostrando valores indefinidos después de aplicar un tipo?
Vuelve a seleccionar la función y deja terminar el análisis; después confirma que aplicaste el tipo a la dirección que realmente lee la función. Una firma incorrecta, profundidad de puntero o mapa de memoria equivocado puede mantener conversiones y valores indefinidos.