
tipi di dati Ghidra: che cosa significano
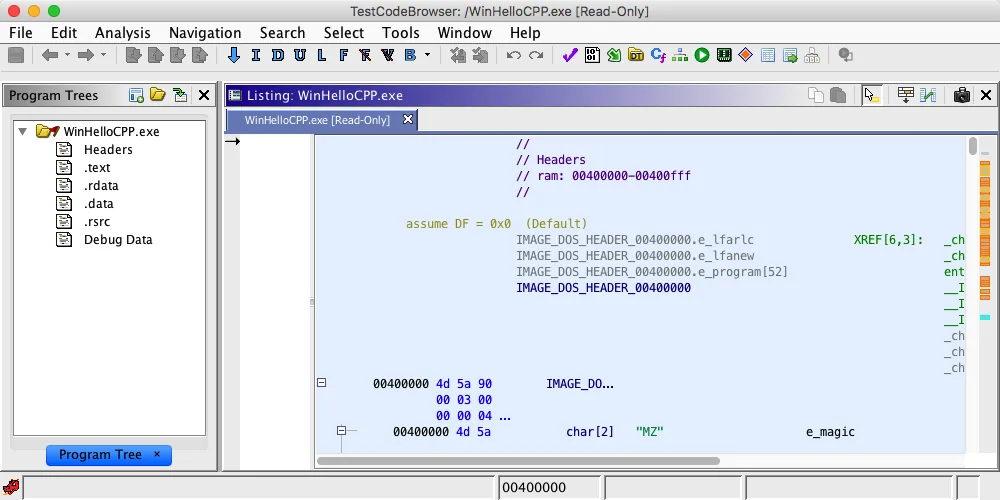
I tipi di dati Ghidra descrivono come leggere un intervallo di byte. Un programma appena importato contiene byte indefiniti, spesso mostrati con punti interrogativi, finché l'analisi o l'analista non applica un tipo. Applicare un tipo non riscrive il file originale: aggiunge un'interpretazione al modello del programma. Un byte può essere un intero con segno, un puntatore, una stringa, un campo di struttura, un elemento di array o un altro tipo supportato.
Il confine importante è tra prova e interpretazione. Byte, indirizzo, linguaggio del processore, endianess, riferimenti e schema di accesso ripetuto sono prove. Un'etichetta come `header`, `count` o `next` è un'interpretazione e deve essere sostenuta da questi fatti. Un buon flusso per i tipi di dati Ghidra registra perché un tipo è stato scelto, controlla dimensione e allineamento e conserva una copia del progetto quando l'ipotesi cambia. Tipi diversi possono spiegare gli stessi byte, quindi la traccia delle prove conta.
Questa pagina riguarda la modellazione dei dati in CodeBrowser. La guida al Decompiler di Ghidra spiega come tipi migliori rendano leggibile il pseudocodice, mentre la guida alla ricerca in Ghidra aiuta a trovare prima l'indirizzo o la stringa da modellare.
Usa il tipo che spiega byte e accessi osservati con il minor numero di supposizioni non dimostrate. Se riferimenti successivi non coincidono, annulla o sostituisci il tipo invece di costringere il Decompiler a sembrare ordinato.
| Concetto | Che cosa indica | Che cosa verificare |
|---|---|---|
| Dati indefiniti | I byte non hanno ancora un'interpretazione impegnativa | Indirizzo, blocco, codifica e riferimenti vicini |
| Tipo primitivo | Dimensione e rappresentazione del valore sono note | Linguaggio, segno, endianess e allineamento |
| Struttura | Campi nominati a offset espliciti | Ordine, padding, dimensione e accessi ripetuti |
| Puntatore | Un valore interpretato come indirizzo | Spazio degli indirizzi, tipo destinazione e riferimenti validi |
| Array | Elementi ripetuti con passo fisso | Tipo elemento, conteggio e intervallo totale |
tipi di dati Ghidra: aprire Data Type Manager e scegliere una categoria
Apri il programma in CodeBrowser e porta in primo piano la finestra Data Type Manager dal menu Window. La posizione dipende dal layout, ma il manager separa normalmente tipi integrati, tipi forniti dal programma corrente e tipi caricati dagli archivi. Inizia dalla categoria del programma e dalla famiglia davvero necessaria; importare un archivio enorme può nascondere i pochi tipi utili al campione.
I tipi integrati sono adatti a valori primitivi e stringhe comuni. I tipi del programma sono il posto più sicuro per una struttura ancora in verifica, perché viaggiano con il progetto. Gli archivi possono fornire definizioni note di piattaforma o libreria, ma un nome uguale non dimostra lo stesso ABI, packing o versione. Annota origine e livello di fiducia del tipo importato e confronta le alternative prima di sceglierne una.
Prima di modificare un indirizzo selezionato, annota indirizzo, visualizzazione corrente e numero di byte previsti. Questa baseline rende visibile una sovrascrittura accidentale e permette di confrontare il Listing prima e dopo.
- 1
tipi di dati Ghidra: selezionare programma e indirizzo
Apri un binario di prova o un campione autorizzato, scegli un indirizzo nel Listing e conferma programma e blocco di memoria attivi.
Program -> CodeBrowser -> Listing - 2
tipi di dati Ghidra: mostrare il manager
Scegli Window > Data Type Manager ed espandi le categorie senza importare un archivio superfluo.
Window -> Data Type Manager - 3
tipi di dati Ghidra: scegliere la fonte più stretta
Usa un tipo integrato per un primitivo, un tipo di programma per una struttura in evoluzione e un archivio solo con ABI compatibile.
BuiltIn / Program / Archive - 4
tipi di dati Ghidra: registrare la baseline
Annota indirizzo, byte correnti, nome del blocco, linguaggio e dimensione attesa prima di applicare un tipo.
address + bytes + expected size
tipi di dati Ghidra: applicare primitivi senza perdere il contesto dei byte
I primitivi sono il punto di partenza più sicuro quando la prova indica una larghezza o una codifica note. Byte, word, dword, qword, carattere, booleano, float o puntatore cambiano la visualizzazione nel Listing senza cambiare il file su disco. Seleziona l'intervallo corretto, usa il comando dati o trascina un tipo dal Data Type Manager e controlla subito la dimensione. Conserva nelle note i tipi alternativi quando la prova è ambigua.
Non assumere che un intero abbia la stessa larghezza in ogni linguaggio di processore. Linguaggio e specifica del compilatore determinano dimensione e rappresentazione di molti tipi integrati. Il segno cambia il significato del bit alto, mentre l'endianness cambia l'ordine con cui più byte formano un valore. Se il valore è usato come indirizzo, prova un puntatore solo dopo aver confermato spazio degli indirizzi e riferimenti vicini.
Quando una definizione consuma byte che dovrebbero restare separati, annulla e restringi la selezione. Un comando riuscito non equivale a un modello corretto. Registra byte originali e indirizzo finale previsto per scoprire intervalli fuori di uno o buchi di allineamento.
- Controlla linguaggio del processore e dimensione degli indirizzi prima di scegliere un tipo multi-byte.
- Usa larghezza degli accessi e operandi delle istruzioni come prova per segno e dimensione.
- Tratta un puntatore come ipotesi di indirizzo e verifica la destinazione nello spazio attivo.
- Applica una definizione alla volta quando impari un binario, così un intervallo errato è facile da annullare.
- Annota i byte indefiniti tra due campi noti: possono essere padding o un campo mancante.
address: 0x00402010 | size: 4 | observed: little-endian load | type: uint32_t | confidence: mediumbytes -> type -> Listing check -> reference check -> Decompiler checktipi di dati Ghidra: creare e applicare una struttura
Crea una struttura quando più campi vengono usati a offset stabili dalla stessa base. Una struttura non è un elenco di supposizioni: definisce ordine, offset, dimensioni e spesso una lunghezza totale. Parti dal gruppo minimo di campi sostenuto da load e store ripetuti. Puoi aggiungere nomi e tipi quando emergono prove, ma cambiare la dimensione di un campo sposta tutti quelli successivi e modifica l'interpretazione dei chiamanti.
Nel Data Type Manager crea una struttura nella categoria del programma, assegnale un nome provvisorio descrittivo e aggiungi i campi in ordine di offset. Usa padding esplicito solo se il vuoto è sostenuto da allineamento o accessi osservati. Se un campo è un puntatore, applica la destinazione più difendibile, non una struttura scelta solo perché il nome sembra familiare. Un nodo autoriferito può puntare alla struttura in definizione, ma verifica che il binario segua davvero quel puntatore.
Dopo aver definito la struttura, applicala all'indirizzo base nel Listing. Controlla ogni confine e confronta la dimensione totale con l'oggetto noto successivo o con un'altra istanza. Due istanze a passo costante sono una buona prova per un array di strutture. Se il prossimo oggetto parte a un offset inatteso, lascia visibile il vuoto finché non sai se è padding, union, versione diversa o campo errato.
- 1
tipi di dati Ghidra: creare una struttura del programma
In Data Type Manager scegli la categoria del programma, crea una struttura e usa un nome provvisorio che descriva le prove, non un significato inventato.
Program Types -> New -> Structure - 2
tipi di dati Ghidra: aggiungere campi per offset
Inserisci campi primitivi, array, enum o puntatori noti. Lascia byte ignoti indefiniti o come padding esplicito finché un riferimento non li sostiene.
offset 0x00 -> field_0; offset 0x04 -> field_4 - 3
tipi di dati Ghidra: applicare alla base
Seleziona la base nel Listing, applica la struttura e verifica che ogni campo finisca dove lo aspetta l'accesso successivo.
Listing -> Data -> apply structure - 4
tipi di dati Ghidra: confrontare istanze ripetute
Cerca lo stesso schema o passo a un altro indirizzo prima di rinominare la struttura come oggetto confermato.
base + stride -> second instance
| Decisione sulla struttura | Prova utile | Rischio se indovinata |
|---|---|---|
| Dimensione campo | Larghezza load/store e offset ripetuto | Ogni campo successivo si sposta |
| Padding | Confine di allineamento o vuoto costante | Un campo reale viene nascosto o la struttura cresce troppo |
| Destinazione puntatore | Dereferenziazione e riferimenti validi | Il Decompiler mostra un grafo fuorviante |
| Lunghezza struttura | Oggetto successivo, passo array o dimensione allocata | Array e chiamanti diventano incoerenti |
tipi di dati Ghidra: usare array, enum, typedef e puntatori
Un array è adatto quando lo stesso tipo di elemento si ripete con un passo prevedibile. Definisci prima l'elemento, poi imposta il conteggio solo se è sostenuto da limite di ciclo, lunghezza tabella, oggetto vicino o dimensione allocata. Un conteggio indovinato può far sembrare validi byte estranei. Per stringhe terminate da zero o buffer a dimensione variabile, mantieni esplicito il limite invece di forzare un array fisso.
Gli enum migliorano la leggibilità quando un valore viene confrontato con pochi costanti ripetute. Nomina soltanto valori sostenuti da confronto o documentazione e lascia visibile il valore sconosciuto. I typedef danno un nome stabile a un primitivo o puntatore ripetuto, ma non creano nuove prove; sono più utili quando tipo sottostante e convenzione di chiamata sono chiari.
I puntatori richiedono più disciplina perché un valore è significativo solo in uno spazio di indirizzi. Conferma se punta a struttura, stringa, funzione o tabella e controlla almeno un riferimento reale. Una catena elegante nel Decompiler può essere errata se base, segmento o larghezza sono sbagliati. Annota sempre destinazione e assunzione sullo spazio.
È meglio mostrare un byte indefinito o un enum sconosciuto che rendere certo un oggetto solo in apparenza. L'incertezza visibile può essere verificata; un campo inventato no.
| Schema di tipo | Usalo quando | Confine da registrare |
|---|---|---|
| Array | Gli elementi si ripetono con passo noto | Tipo e conteggio o regola di terminazione |
| Enum | Un valore è confrontato con costanti nominate | Valori noti più un caso sconosciuto esplicito |
| Typedef | Un tipo provato necessita di un nome riutilizzabile | Tipo sottostante e convenzione di chiamata |
| Puntatore | Il valore viene dereferenziato o usato come indirizzo | Spazio degli indirizzi e destinazione |
| Puntatore a funzione | Una tabella o chiamata usa un salto indiretto | Prototipo, passo tabella e prova della chiamata |
tipi di dati Ghidra: verificare Listing e Decompiler
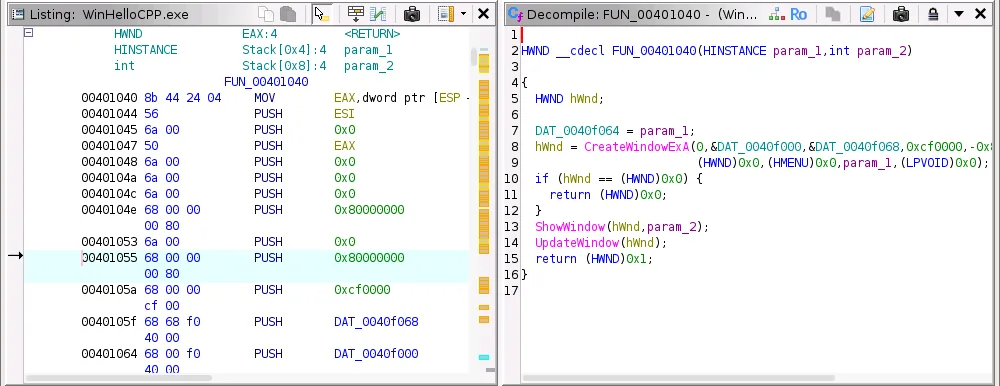
Dopo aver applicato un tipo, torna al Listing e controlla byte esatti, indirizzo, offset dei campi e riferimenti. Conferma che la definizione resti nel blocco di memoria previsto e che i valori mostrati coincidano con load/store. Se si sovrappone a istruzioni o a una stringa nota, fermati e annulla. Il Listing è il registro a livello di indirizzo e deve restare comprensibile anche prima dell'aggiornamento del Decompiler.
Poi seleziona una funzione che legge l'oggetto tipizzato e apri Decompiler. Una firma, struttura o puntatore migliore può sostituire valori indefiniti e cast con nomi di campo, ma questo è un controllo di coerenza, non una prova. Confronta istruzioni decisive con il pseudocodice, inclusi segno, aritmetica dei puntatori, indici di array e valori restituiti. Se l'output cambia dopo l'analisi, registra il cambiamento e ricontrolla le prove.
Esamina i tipi come modello collegato, non come etichette isolate. I tipi nel Listing devono corrispondere alla firma, alle dereferenziazioni e ai passi degli array. Quando divergono, mantieni il tipo più semplice sostenuto dalle prove, marca quello incerto come provvisorio e testalo su un altro riferimento prima di dare un nome definitivo.
Usa la guida Function Graph quando un campo viene letto in più rami e la guida all'analisi firmware quando la mappa degli indirizzi è incerta. Queste pagine rispondono a domande vicine; questa resta dedicata al modello dei dati e ai suoi confini.
tipi di dati Ghidra: correggere dimensioni, offset e viste obsolete
Quando un tipo appare errato, cerca il disaccordo più piccolo. Controlla linguaggio del processore, spazio degli indirizzi, ordine dei byte, intervallo selezionato e firma prima di cambiare più campi insieme. Un puntatore a 64 bit applicato a una tabella a 32 bit o una struttura packed su dati allineati può rompere ogni accesso successivo. Annulla l'ultima modifica, confronta i byte e verifica un'unica ipotesi.
Anche una vista Decompiler obsoleta può ingannare. Lascia finire l'analisi, aggiorna o riseleziona la funzione e verifica che Listing e Decompiler puntino allo stesso indirizzo. Se un archivio offre un nome simile, controlla dimensione e packing sottostanti invece di supporre compatibilità. Conserva una copia del progetto prima di modifiche ampie, così un esperimento errato resta reversibile.
Annota indirizzo, tipo, linguaggio e modifica che hanno prodotto il problema. Una breve nota prima/dopo vale più di nuovi tentativi casuali sulla struttura.
| Sintomo | Controlla prima | Azione più sicura |
|---|---|---|
| I campi si spostano dopo la struttura | Dimensioni, padding e linguaggio | Annulla, lascia il vuoto indefinito e ricostruisci dagli offset |
| Il puntatore esce dalla memoria | Spazio, base e larghezza | Trattalo come intero finché trovi una destinazione valida |
| Decompiler mostra molti cast | Firma, segno e destinazione | Verifica un chiamante e un load/store nel Listing |
| L'array consuma byte estranei | Conteggio, passo e terminazione | Usa conteggio più breve o limite dinamico |
| Il tipo manca dal manager | Categoria, percorso archivio e filtro | Aggiorna e importa solo un archivio verificato |
tipi di dati Ghidra: un flusso di lavoro ripetibile
Una sessione affidabile di modellazione è piccola, esplicita e facile da revisionare. Parti da un indizio come offset ripetuto, lunghezza nota, dereferenziazione o confronto costante. Registra indirizzo e byte, scegli il tipo più stretto che spiega l'indizio e verifica il risultato nel Listing prima di aggiungere nomi. Solo dopo passa a struttura, array, enum o puntatore che combini più osservazioni sostenute.
Per un team o un'indagine ripetuta conserva versione del progetto, linguaggio del processore, fonte del tipo e livello di fiducia per ogni definizione importante. Tieni separati i tipi del programma dagli import speculativi e confronta di nuovo quando un chiamante non concorda. Usa la guida Script Manager solo dopo aver capito l'operazione manuale: uno script applica un buon modello con coerenza, ma può diffondere rapidamente un'ipotesi sbagliata.
L'obiettivo non è far sembrare ogni riga codice sorgente. È costruire un modello che spieghi byte, riferimenti e flusso di controllo mostrando ciò che resta ignoto. Mantieni tipi, offset e destinazioni verificabili, così il prossimo analista saprà dove testare, correggere o automatizzare l'interpretazione.
- 1
tipi di dati Ghidra: ancorare
Parti da indirizzo, riferimento, limite di ciclo o accesso ripetuto visibile nel Listing.
evidence -> address - 2
tipi di dati Ghidra: modellare
Applica il tipo primitivo o di campo minimo che spiega larghezza e rappresentazione osservate.
address -> type - 3
tipi di dati Ghidra: controllare
Confronta byte, offset, riferimenti e un consumatore Decompiler prima di aggiungere nomi o padding.
Listing -> Decompiler - 4
tipi di dati Ghidra: conservare
Salva una copia del progetto e annota motivo, fiducia e percorso di ripristino del modello.
type + evidence + rollback
- Usa binari autorizzati e lascia invariati i file originali.
- Separa nelle note offset del file, indirizzi caricati e destinazioni dei puntatori.
- Preferisci un'incertezza visibile a un campo o conteggio basato solo su una supposizione.
- Ricontrolla i chiamanti dopo aver cambiato struttura o firma di funzione.
- Automatizza solo dopo che un esempio manuale è corretto e ripetibile.
Domande sui tipi di dati Ghidra
A che cosa servono i tipi di dati Ghidra?
I tipi di dati Ghidra descrivono come byte devono essere mostrati e interpretati nel modello del programma. Permettono di definire primitivi, stringhe, strutture, array, enum e puntatori, quindi di verificarli in Listing e Decompiler.
Come creo una struttura in Ghidra?
Apri Data Type Manager, crea una struttura nella categoria del programma corrente, aggiungi campi in ordine di offset, lascia indefiniti i vuoti non provati o usa padding motivato, poi applica la struttura alla base nel Listing.
Perché i campi della struttura Ghidra hanno offset errati?
Controlla linguaggio del processore, dimensioni dei campi, allineamento, packing e padding esplicito. Annulla la definizione, confronta i byte originali e ricostruisci la struttura minima sostenuta dagli accessi ripetuti.
Devo definire un tipo puntatore in Ghidra?
Definisci un puntatore quando il valore è usato come indirizzo e almeno un riferimento sostiene spazio e destinazione. Senza questa prova, mantienilo come intero o tipo di dimensione ignota finché la destinazione non è verificata.
Un tipo di dati Ghidra può cambiare il binario originale?
Applicare un tipo cambia il modello del progetto e le sue viste, non il file di input originale. Conserva una copia del progetto e note quando fai modifiche ampie.
Perché Decompiler mostra ancora valori indefiniti dopo un tipo?
Riseleziona la funzione e lascia terminare l'analisi, poi conferma che il tipo sia applicato all'indirizzo realmente letto. Firma errata, profondità del puntatore o mappa di memoria possono mantenere cast e valori indefiniti nel pseudocodice.