
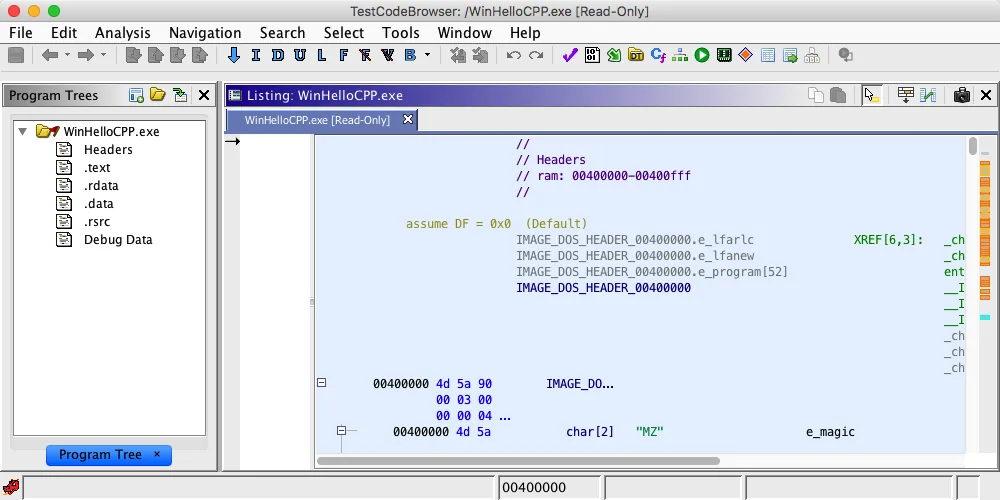
Ghidra-Datentypen: Was sie bedeuten
Ghidra-Datentypen beschreiben, wie ein Bytebereich gelesen werden soll. Ein frisch importiertes Programm enthält undefinierte Bytes, die oft als Fragezeichen erscheinen, bis die Analyse oder ein Analyst einen Typ anwendet. Ein Typ überschreibt nicht die ursprüngliche Datei. Er ergänzt das Programmmodell: Ein Byte kann eine vorzeichenbehaftete Ganzzahl, ein Zeiger, eine Zeichenkette, ein Strukturfeld, ein Arrayelement oder ein anderer unterstützter Datentyp sein.
Die wichtige Grenze verläuft zwischen Beleg und Interpretation. Bytes, Adresse, Prozessor-Sprache, Endianness, Verweise und wiederholte Zugriffsmuster sind Belege. Ein Name wie `header`, `count` oder `next` ist eine Interpretation, die von diesen Fakten getragen werden sollte. Ein guter Workflow für Ghidra-Datentypen hält fest, warum ein Typ gewählt wurde, prüft Größe und Ausrichtung und bewahrt eine Projektkopie auf, falls sich die Hypothese ändert. Verschiedene Typen können dieselben Bytes erklären; deshalb ist die Belegkette wichtig.
Diese Seite behandelt die Datenmodellierung in CodeBrowser. Der Ghidra-Decompiler-Leitfaden erklärt, wie bessere Typen Pseudocode lesbarer machen. Der Ghidra-Suchleitfaden hilft, zuerst die Adresse oder Zeichenkette zu finden, die modelliert werden soll.
Verwenden Sie den Typ, der die beobachteten Bytes und Zugriffsmuster mit den wenigsten unbelegten Annahmen erklärt. Widersprechen spätere Verweise, machen Sie die Änderung rückgängig oder ersetzen Sie den Typ, statt den Decompiler nur sauber aussehen zu lassen.
| Konzept | Aussage | Zu prüfen |
|---|---|---|
| Undefinierte Daten | Bytes haben noch keine verbindliche Interpretation | Adresse, Block, Kodierung und nahe Verweise |
| Primitiver Typ | Bekannte Größe und Wertdarstellung | Sprache, Vorzeichen, Endianness und Ausrichtung |
| Struktur | Benannte Felder an festen Offsets | Feldreihenfolge, Padding, Größe und wiederholte Zugriffe |
| Zeiger | Ein Wert wird als Adresse interpretiert | Adressraum, Zieltyp und gültige Verweise |
| Array | Wiederholte Elemente mit festem Schritt | Elementtyp, Anzahl und gesamter Bytebereich |
Ghidra-Datentypen: Data Type Manager öffnen
Öffnen Sie das Programm in CodeBrowser und holen Sie das Fenster Data Type Manager über das Menü Window nach vorn. Die genaue Docking-Position hängt vom Arbeitsbereich ab. Normalerweise trennt der Manager integrierte Typen, programmspezifische Typen und Typen aus Archiven. Beginnen Sie mit der Programmkategorie und der benötigten Typfamilie. Ein großes Archiv kann die wenigen Typen verdecken, die für die aktuelle Probe relevant sind.
Integrierte Typen eignen sich für primitive Werte und übliche Zeichenketten. Programmspezifische Typen sind der sicherste Ort für eine noch getestete Struktur, weil sie mit dem Projekt gespeichert werden. Archive liefern bekannte Plattform- oder Bibliotheksdefinitionen; ein gleicher Name beweist aber nicht dieselbe ABI, dasselbe Packing oder dieselbe Version. Notieren Sie Quelle und Vertrauen eines importierten Typs und vergleichen Sie Kandidaten, bevor Sie sich festlegen.
Bevor Sie eine ausgewählte Adresse ändern, notieren Sie Adresse, aktuelle Anzeige und erwartete Byteanzahl. Diese einfache Ausgangsbasis macht ein versehentliches Überschreiben sichtbar und erlaubt den Vergleich des Listings vor und nach der Aktion.
- 1
Programm und Adresse wählen – Ghidra-Datentypen
Öffnen Sie eine Übungsdatei oder eine autorisierte Probe, wählen Sie eine Listing-Adresse und bestätigen Sie aktives Programm und Speicherblock.
Program -> CodeBrowser -> Listing - 2
Manager anzeigen – Ghidra-Datentypen
Wählen Sie Window > Data Type Manager und öffnen Sie Kategorien, ohne ein unnötiges Archiv zu importieren.
Window -> Data Type Manager - 3
Engste Quelle wählen – Ghidra-Datentypen
Verwenden Sie einen integrierten Typ für Primitive, einen Programmtyp für eine wachsende Struktur und ein Archiv nur bei passender ABI.
BuiltIn / Program / Archive - 4
Ausgangsbasis festhalten – Ghidra-Datentypen
Notieren Sie Adresse, Bytes, Blockname, Sprache und erwartete Größe, bevor Sie einen Typ anwenden.
address + bytes + expected size
Ghidra-Datentypen: Primitive Typen mit Bytekontext anwenden
Primitive Typen sind ein sicherer Anfang, wenn Belege eine bekannte Breite oder Kodierung zeigen. Byte, Word, Dword, Qword, Zeichen, Boolean, Float oder Zeiger ändern die Anzeige derselben Bytes im Listing, nicht die Datei auf der Festplatte. Wählen Sie den passenden Adressbereich, nutzen Sie den Datenbefehl oder ziehen Sie einen Typ aus dem Data Type Manager und prüfen Sie sofort die resultierende Größe. Halten Sie alternative Typen in Ihren Notizen fest, solange die Belege mehrdeutig sind.
Nehmen Sie nicht an, dass eine Ganzzahl in jeder Prozessor-Sprache dieselbe Breite besitzt. Sprache und Compiler-Spezifikation bestimmen Größe und Darstellung vieler integrierter Typen. Auch das Vorzeichen ändert die Bedeutung des höchsten Bits, während die Endianness die Reihenfolge mehrerer Bytes bestimmt. Wird der Wert als Adresse verwendet, testen Sie eine Zeigerinterpretation erst nach Prüfung von Adressraum und nahen Verweisen.
Verbraucht eine Definition Bytes, die getrennt bleiben sollten, machen Sie die Aktion rückgängig und verkleinern Sie die Auswahl. Ein erfolgreicher Befehl ist noch kein korrektes Modell. Notieren Sie Originalbytes und erwartete Endadresse, damit ein Bereichsfehler oder eine Ausrichtungslücke auffällt.
- Prüfen Sie Prozessor-Sprache und Adressgröße vor einem Mehrbyte-Typ.
- Nutzen Sie beobachtete Zugriffsbreite und Operanden als Belege für Vorzeichen und Größe.
- Behandeln Sie einen Zeiger als Adresshypothese und prüfen Sie sein Ziel im aktiven Speicherraum.
- Wenden Sie beim Lernen an einer neuen Binärdatei eine Definition nach der anderen an, damit ein falscher Bereich leicht rückgängig wird.
- Notieren Sie undefinierte Bytes zwischen bekannten Feldern; Lücken können Padding oder ein fehlendes Feld sein.
address: 0x00402010 | size: 4 | observed: little-endian load | type: uint32_t | confidence: mediumbytes -> type -> Listing check -> reference check -> Decompiler checkGhidra-Datentypen: Struktur erstellen und anwenden
Erstellen Sie eine Struktur, wenn mehrere Felder bei stabilen Offsets von derselben Basis gelesen werden. Eine Struktur ist mehr als eine Liste von Vermutungen: Sie legt Feldreihenfolge, Offsets, Größen und meist eine Gesamtlänge fest. Beginnen Sie mit den wenigen Feldern, die durch wiederholte Loads und Stores belegt sind. Namen und Typen können später ergänzt werden; eine Größenänderung verschiebt jedoch alle folgenden Felder und verändert die Interpretation der Aufrufer.
Erstellen Sie im Data Type Manager eine neue Struktur in der Programmkategorie, geben Sie ihr einen vorläufigen beschreibenden Namen und fügen Sie Felder in Offset-Reihenfolge ein. Nutzen Sie explizites Padding nur, wenn Ausrichtung oder Zugriffe die Lücke stützen. Ist ein Feld ein Zeiger, verwenden Sie den plausibelsten Zieltyp und keinen beliebigen Typ, dessen Name vertraut klingt. Ein selbstreferenzieller Knoten kann auf die gerade definierte Struktur zeigen; prüfen Sie trotzdem, ob die Binärdatei den Zeiger tatsächlich verfolgt.
Wenden Sie die fertige Struktur an der Basisadresse im Listing an. Prüfen Sie jede Feldgrenze und vergleichen Sie die Gesamtgröße mit dem nächsten bekannten Objekt oder einer wiederholten Instanz. Treten zwei Instanzen mit konstantem Schritt auf, spricht das für ein Struktur-Array. Beginnt das nächste Objekt an einem unerwarteten Offset, lassen Sie die Lücke sichtbar, bis Padding, Union, andere Version oder ein falscher Feldtyp geklärt ist.
- 1
Programstruktur erstellen – Ghidra-Datentypen
Wählen Sie im Data Type Manager die Programmkategorie, erstellen Sie eine Struktur und verwenden Sie einen vorläufigen Namen, der die Belege beschreibt.
Program Types -> New -> Structure - 2
Felder nach Offset ergänzen – Ghidra-Datentypen
Fügen Sie bekannte Primitive, Arrays, Enums oder Zeiger hinzu. Lassen Sie unbekannte Bytes undefiniert oder als begründetes Padding bestehen.
offset 0x00 -> field_0; offset 0x04 -> field_4 - 3
An der Basis anwenden – Ghidra-Datentypen
Wählen Sie die Basisadresse im Listing, wenden Sie die Struktur an und prüfen Sie, ob jedes Feld dort endet, wo der nächste Zugriff es erwartet.
Listing -> Data -> apply structure - 4
Instanzen vergleichen – Ghidra-Datentypen
Suchen Sie vor einer endgültigen Objektbenennung ein gleiches Zugriffsmuster oder denselben Schritt an einer weiteren Adresse.
base + stride -> second instance
| Strukturentscheidung | Nützlicher Beleg | Risiko einer Vermutung |
|---|---|---|
| Feldgröße | Load-/Store-Breite und wiederholter Offset | Alle folgenden Felder verschieben sich |
| Padding | Ausrichtungsgrenze oder gleichmäßige Lücke | Reales Feld wird verborgen oder Struktur zu groß |
| Zeigerziel | Dereferenzierung und gültige Zielverweise | Decompiler zeigt einen irreführenden Objektgraphen |
| Strukturlänge | Nächstes Objekt, Array-Schritt oder Allokatorgröße | Arrays und Aufrufer werden inkonsistent |
Ghidra-Datentypen: Arrays, Enums, Typedefs und Zeiger
Ein Array passt, wenn sich derselbe Elementtyp mit vorhersehbarem Schritt wiederholt. Definieren Sie zuerst den Elementtyp und setzen Sie die Anzahl nur dann, wenn Schleifengrenze, Tabellenlänge, Nachbarobjekt oder Allokationsgröße sie stützt. Eine geratene Anzahl kann fremde Bytes wie gültige Elemente aussehen lassen. Bei nullterminierten Zeichenketten oder Laufzeitpuffern bleibt die Grenze explizit, statt ein unbelegtes festes Array zu erzwingen.
Enums verbessern die Lesbarkeit, wenn ein Wert mit einer kleinen, wiederholten Konstantenmenge verglichen wird. Benennen Sie nur Werte, die Vergleich oder Dokumentation stützen, und lassen Sie unbekannte Werte sichtbar. Typedefs geben einem bewährten primitiven Typ oder Zeiger einen stabilen Projektnamen, schaffen aber keinen neuen Beleg. Am nützlichsten sind sie, wenn zugrunde liegender Typ und Aufrufkonvention schon klar sind.
Zeiger erfordern besondere Disziplin, denn ein Zeigerwert ist nur in einem Adressraum sinnvoll. Bestätigen Sie, ob er auf Struktur, Zeichenkette, Funktion oder Tabelle zeigt, und prüfen Sie mindestens einen echten Verweis. Eine elegante Zeigerkette im Decompiler kann falsch sein, wenn Basisadresse, Segment oder Typbreite nicht stimmen. Halten Sie Zieltyp und Annahme zum Adressraum in den Notizen sichtbar.
Ein sichtbares undefiniertes Byte oder ein unbekannter Enum-Wert ist besser als ein scheinbar sicheres Objekt. Sichtbare Unsicherheit kann geprüft werden; ein erfundenes Feld nicht.
| Typmuster | Verwendung | Zu dokumentierende Grenze |
|---|---|---|
| Array | Elemente wiederholen sich mit bekanntem Schritt | Elementtyp sowie Anzahl oder Terminierungsregel |
| Enum | Wert wird mit benannten Konstanten verglichen | Bekannte Werte plus expliziter unbekannter Fall |
| Typedef | Bewährter Typ braucht einen wiederverwendbaren Projektnamen | Basistyp und Aufrufkonvention |
| Zeiger | Wert wird dereferenziert oder als Adresse benutzt | Adressraum und Zieltyp |
| Funktionszeiger | Tabelle oder Aufrufstelle nutzt indirekten Aufruf | Prototyp, Tabellen-Schritt und Aufrufbeleg |
Ghidra-Datentypen in Listing und Decompiler prüfen
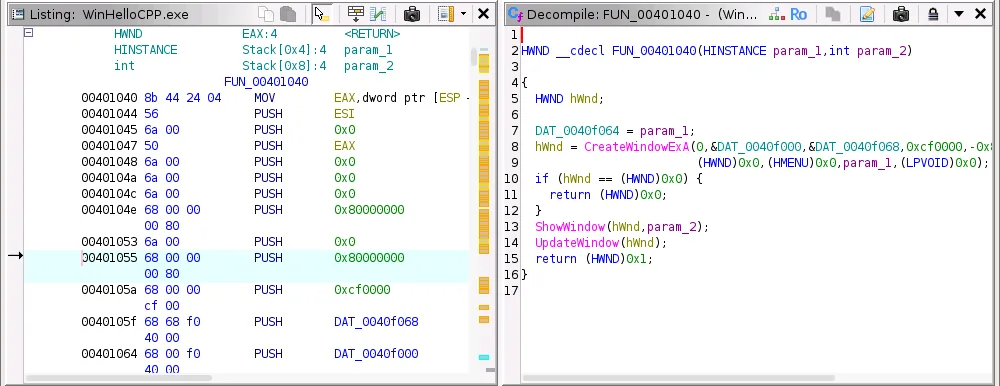
Kehren Sie nach dem Anwenden eines Typs zum Listing zurück und prüfen Sie exakte Bytes, Adresse, Feldoffsets und Verweise. Bestätigen Sie, dass die Datendefinition innerhalb des vorgesehenen Speicherblocks bleibt und angezeigte Werte zu Load-/Store-Befehlen passen. Überlappt die Definition eine Instruktion oder bekannte Zeichenkette, stoppen Sie und machen Sie sie rückgängig. Das Listing ist das Adressprotokoll und sollte verständlich bleiben, auch wenn der Decompiler noch nicht aktualisiert ist.
Wählen Sie danach eine Funktion, die das typisierte Objekt liest, und öffnen Sie den Decompiler. Eine bessere Signatur, Struktur oder ein Zeiger kann undefinierte Werte und Casts durch Feldnamen ersetzen; das ist eine Konsistenzprüfung, kein Beweis. Vergleichen Sie ein oder zwei entscheidende Instruktionen mit dem Pseudocode, einschließlich Vorzeichen, Zeigerarithmetik, Arrayindex und Rückgabewerten. Wenn sich die Ausgabe nach Abschluss der Analyse ändert, notieren Sie das und prüfen die ursprünglichen Belege erneut.
Bewerten Sie Typen als verbundenes Modell statt als einzelne Labels. Typen im Listing müssen zu Funktionssignatur, Dereferenzierungen und Array-Schritten passen. Bei Widerspruch bleiben die einfachsten beleggestützten Typen bestehen; unsichere Typen werden vorläufig markiert und an einem weiteren Verweis getestet, bevor ein Objekt sicher benannt wird.
Nutzen Sie den Function-Graph-Leitfaden, wenn ein Feld in mehreren Zweigen gelesen wird, und den Firmware-Analyseleitfaden, wenn der Adressplan unsicher ist. Diese Seiten behandeln Nachbarfragen; diese Seite bleibt für Datenmodell und Grenzen zuständig.
Ghidra-Datentypen: Falsche Größen, Offsets und alte Ansichten korrigieren
Beginnen Sie bei einem falschen Typ mit der kleinsten Abweichung. Prüfen Sie aktive Prozessor-Sprache, Adressraum, Byte-Reihenfolge, Auswahlbereich und Funktionssignatur, bevor Sie mehrere Felder ändern. Ein 64-Bit-Zeiger in einer 32-Bit-Tabelle oder eine gepackte Struktur auf natürlich ausgerichteten Daten kann jeden späteren Zugriff beschädigen. Machen Sie die letzte Änderung rückgängig, vergleichen Sie Bytes und testen Sie jeweils eine Annahme.
Auch eine veraltete Decompiler-Ansicht kann täuschen. Lassen Sie die Hintergrundanalyse enden, aktualisieren Sie die Funktion oder wählen Sie sie erneut und prüfen Sie, dass Listing und Decompiler dieselbe Adresse zeigen. Liefert ein Typarchiv einen ähnlichen Namen, kontrollieren Sie Größe und Packing statt Kompatibilität anzunehmen. Vergleichen Sie Typen erneut, wenn ein Aufrufer widerspricht, und bewahren Sie vor großen Änderungen eine Projektkopie auf.
Notieren Sie exakte Adresse, Typ, Sprache und Änderung, die das Problem erzeugt hat. Eine kurze Vorher-Nachher-Notiz ist nützlicher als wiederholtes Raten über eine neue Struktur.
| Symptom | Zuerst prüfen | Sicherer nächster Schritt |
|---|---|---|
| Felder verschieben sich nach Struktur-Anwendung | Feldgrößen, Padding und Sprache | Rückgängig machen, Lücke undefiniert lassen und aus Offsets neu bauen |
| Zeiger zeigt außerhalb des Speichers | Adressraum, Basis und Zeigerbreite | Bis zum gültigen Ziel als Ganzzahl behandeln |
| Decompiler zeigt viele Casts | Signatur, Vorzeichen und Zieltyp | Einen Aufrufer sowie Load/Store im Listing prüfen |
| Array verbraucht fremde Bytes | Anzahl, Schritt und Terminierung | Kürzere Anzahl oder Laufzeitgrenze verwenden |
| Typ fehlt im Manager | Kategorie, Archivpfad und Filter | Aktualisieren und nur geprüftes Archiv importieren |
Ein wiederholbarer Workflow für Ghidra-Datentypen
Eine verlässliche Datenmodellierung ist klein, ausdrücklich und leicht zu prüfen. Beginnen Sie mit einem Hinweis wie wiederholtem Offset, bekannter Länge, Dereferenzierung oder Konstantenvergleich. Notieren Sie Adresse und Bytes, wählen Sie den engsten Typ, der den Hinweis erklärt, und prüfen Sie das Ergebnis im Listing, bevor Sie Namen ergänzen. Erst danach folgt eine Struktur, ein Array, Enum oder Zeiger, der mehrere belegte Beobachtungen verbindet.
Für Teams oder wiederholte Untersuchungen bewahren Sie Projektversion, Prozessor-Sprache, Typquelle und Vertrauen für jede wichtige Definition auf. Trennen Sie Programmtypen von spekulativen Archivimporten und vergleichen Sie Typen erneut, wenn ein Aufrufer widerspricht. Verwenden Sie den Script-Manager-Leitfaden erst, wenn der manuelle Vorgang verstanden ist. Ein Skript kann ein gutes Modell einheitlich anwenden, aber auch eine schlechte Annahme schnell verbreiten.
Ziel ist nicht, jede Zeile wie Quellcode aussehen zu lassen. Ziel ist ein Modell, das Bytes, Verweise und Kontrollfluss erklärt und zugleich zeigt, was unbekannt bleibt. Halten Sie Typen, Offsets und Zeigerziele prüfbar, damit der nächste Analyst die Interpretation testen, ändern oder automatisieren kann.
- 1
Verankern – Ghidra-Datentypen
Beginnen Sie mit Adresse, Verweis, Schleifengrenze oder wiederholtem Zugriff, den Sie im Listing zeigen können.
evidence -> address - 2
Modellieren – Ghidra-Datentypen
Wenden Sie den kleinsten primitiven oder Feldtyp an, der Breite und Darstellung erklärt.
address -> type - 3
Prüfen – Ghidra-Datentypen
Vergleichen Sie Bytes, Offsets, Verweise und einen Decompiler-Verbraucher, bevor Sie Namen oder Padding ergänzen.
Listing -> Decompiler - 4
Bewahren – Ghidra-Datentypen
Speichern Sie eine Projektkopie und dokumentieren Sie Grund, Vertrauen und Rückweg des Modells.
type + evidence + rollback
- Verwenden Sie autorisierte Binärdateien und lassen Sie Originaldateien unverändert.
- Trennen Sie Datei-Offsets, geladene Adressen und Zeigerziele in den Notizen.
- Bevorzugen Sie sichtbare Unsicherheit gegenüber einem nur geratenen Feld oder Zähler.
- Prüfen Sie Aufrufer erneut, nachdem Sie Struktur oder Funktionssignatur geändert haben.
- Automatisieren Sie erst, wenn ein manueller Fall korrekt und wiederholbar ist.
Fragen zu Ghidra-Datentypen
Wofür werden Ghidra-Datentypen verwendet?
Ghidra-Datentypen beschreiben, wie Bytes im Programmmodell angezeigt und interpretiert werden. Sie definieren Primitive, Zeichenketten, Strukturen, Arrays, Enums und Zeiger und prüfen diese Definitionen anschließend in Listing und Decompiler.
Wie erstelle ich eine Struktur in Ghidra?
Öffnen Sie den Data Type Manager, erstellen Sie eine Struktur in der Programmkategorie, ergänzen Sie Felder nach Offset, lassen Sie unbelegte Lücken undefiniert oder als begründetes Padding bestehen und wenden Sie die Struktur an ihrer Basisadresse im Listing an.
Warum haben meine Ghidra-Strukturfelder falsche Offsets?
Prüfen Sie Prozessor-Sprache, Feldgrößen, Ausrichtung, Packing und explizites Padding. Machen Sie die Definition rückgängig, vergleichen Sie Originalbytes und bauen Sie die kleinste Struktur aus den beobachteten Offsets neu auf.
Soll ich in Ghidra einen Zeigertyp definieren?
Definieren Sie einen Zeiger, wenn der Wert als Adresse verwendet wird und mindestens ein Verweis Adressraum und Ziel stützt. Fehlt dieser Beleg, lassen Sie den Wert als Ganzzahl oder konservativen Typ bestehen, bis das Ziel geprüft ist.
Kann ein Ghidra-Datentyp die ursprüngliche Binärdatei ändern?
Das Anwenden eines Datentyps ändert das Projektmodell und seine Ansichten, nicht die ursprüngliche Eingabedatei. Bewahren Sie eine Projektkopie auf und exportieren Sie bei großen Modelländerungen Notizen.
Warum zeigt der Decompiler nach einer Typanwendung weiter undefinierte Werte?
Wählen Sie die Funktion erneut und lassen Sie die Analyse abschließen. Prüfen Sie dann, dass der Typ auf die tatsächlich gelesene Adresse angewendet wurde. Eine falsche Signatur, Zeigertiefe oder Speicherkarte kann Casts und undefinierte Werte im Pseudocode erhalten.