
Tipos de dados do Ghidra: o que significam
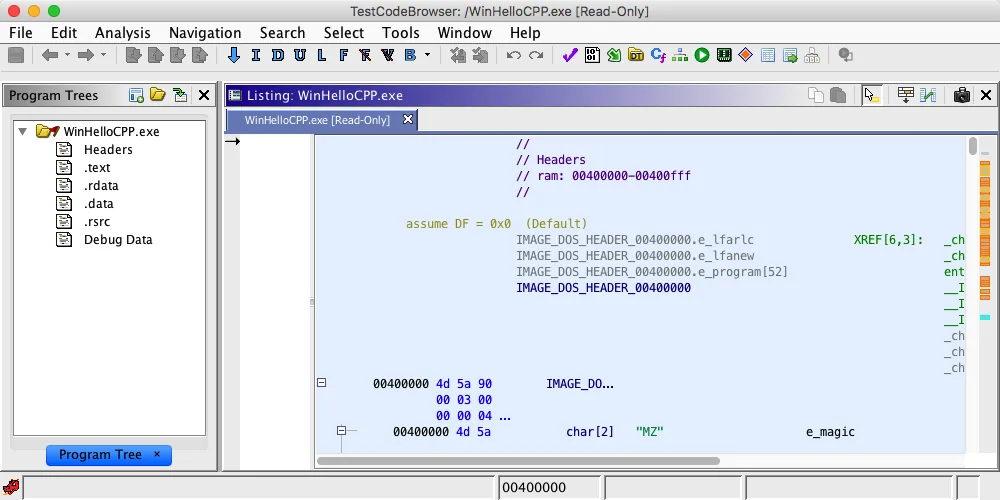
Os tipos de dados do Ghidra descrevem como uma faixa de bytes deve ser lida. Um programa recém-importado contém bytes indefinidos, muitas vezes exibidos como pontos de interrogação, até que a análise ou o analista aplique um tipo. Aplicar um tipo não reescreve o arquivo original. A operação adiciona uma interpretação ao modelo do programa: um byte pode ser um inteiro com sinal, um ponteiro, uma string, um campo de estrutura, um elemento de array ou outro tipo compatível.
A fronteira importante é entre evidência e interpretação. Bytes, endereço, linguagem do processador, endianness, referências e padrão de acesso repetido são evidências. Um rótulo como `header`, `count` ou `next` é uma interpretação que precisa ser sustentada por esses fatos. Um bom fluxo com tipos de dados do Ghidra registra por que um tipo foi escolhido, verifica seu tamanho e alinhamento e mantém uma cópia do projeto disponível quando a hipótese muda. Tipos diferentes podem explicar os mesmos bytes, por isso o caminho da evidência importa.
Esta página se concentra na modelagem de dados dentro do CodeBrowser. O guia do Ghidra Decompiler explica como tipos melhores podem tornar o pseudocódigo mais legível, enquanto o guia de busca do Ghidra ajuda a encontrar primeiro o endereço ou a string que deve ser modelado.
Use o tipo que explica os bytes observados e o padrão de acesso com o menor número de suposições sem suporte. Se referências posteriores discordarem, desfaça ou substitua o tipo em vez de forçar o decompilador a parecer limpo.
| Conceito | O que informa | O que verificar |
|---|---|---|
| Dados indefinidos | Os bytes não têm uma interpretação de dados confirmada | Endereço, bloco, codificação e referências próximas |
| Tipo primitivo | Tamanho conhecido e representação do valor | Linguagem, sinal, endianness e alinhamento |
| Estrutura | Campos nomeados em offsets explícitos | Ordem dos campos, padding, tamanho e acessos repetidos |
| Ponteiro | Valor interpretado como um endereço | Espaço de endereçamento, tipo apontado e referências válidas |
| Array | Elementos repetidos com stride fixo | Tipo do elemento, quantidade e faixa total de bytes |
Tipos de dados do Ghidra: abra o Data Type Manager e escolha uma categoria
Abra o programa no CodeBrowser e traga a janela Data Type Manager para frente pelo menu Window. A posição exata depende do seu espaço de trabalho, mas o gerenciador normalmente separa tipos incorporados, tipos fornecidos pelo programa atual e tipos carregados de arquivos de archive. Comece localizando a categoria do programa e a família de tipos de que realmente precisa; importar um archive grande pode dificultar a visualização do pequeno conjunto relevante para a amostra atual.
Tipos incorporados são úteis para valores primitivos e strings comuns. Tipos do programa são o local mais seguro para uma estrutura ainda em teste, pois acompanham o projeto atual. Archives podem fornecer definições conhecidas de plataforma ou biblioteca, mas um nome correspondente não prova que o alvo use a mesma ABI, compactação ou versão. Registre nas notas de análise a origem e a confiança de um tipo importado. Compare tipos candidatos antes de assumir um deles.
Antes de alterar um endereço selecionado, anote o endereço, a exibição atual e o número de bytes que espera consumir. Essa linha de base simples torna uma sobrescrita acidental visível e permite comparar o Listing antes e depois da operação.
- 1
Selecione um programa e endereço
Abra um binário de prática ou uma amostra autorizada, escolha um endereço no Listing e confirme o programa ativo e o bloco de memória.
Program -> CodeBrowser -> Listing - 2
Mostre o gerenciador
Escolha Window > Data Type Manager e expanda as categorias sem importar um archive desnecessário.
Window -> Data Type Manager - 3
Escolha a fonte mais estreita
Use um tipo incorporado para um primitivo, um tipo do programa para uma estrutura em evolução e um archive somente quando a ABI for compatível.
BuiltIn / Program / Archive - 4
Registre a linha de base
Anote endereço, bytes atuais, nome do bloco, linguagem e tamanho esperado antes de aplicar um tipo.
address + bytes + expected size
Tipos de dados do Ghidra: aplique primitivos sem perder o contexto dos bytes
Tipos primitivos são o ponto de partida mais seguro quando a evidência é uma largura ou codificação conhecida. Um byte, word, dword, qword, caractere, booleano, float ou ponteiro pode mudar a forma como o Listing exibe os mesmos bytes sem modificar o arquivo em disco. Selecione a faixa correta, escolha o comando de dados ou arraste um tipo do Data Type Manager e inspecione imediatamente o tamanho resultante. Mantenha tipos alternativos nas notas quando a evidência ainda for ambígua.
Não presuma que um inteiro tenha a mesma largura em toda linguagem de processador. A linguagem e a especificação do compilador determinam o tamanho e a representação de muitos tipos incorporados. O sinal também muda a interpretação do bit alto, enquanto o endianness muda a ordem em que vários bytes formam um valor. Se o valor for usado como endereço, teste uma interpretação de ponteiro somente depois de confirmar o espaço de endereçamento e as referências próximas.
Quando uma definição consumir bytes que deveriam permanecer separados, desfaça a ação e reduza a seleção. Um comando concluído não é necessariamente um modelo correto. Registre os bytes originais e o endereço final esperado para detectar uma faixa com um byte a mais ou uma lacuna de alinhamento.
- Verifique a linguagem do processador e o tamanho do endereço antes de escolher um tipo com vários bytes.
- Use a largura observada nos acessos e os operandos das instruções como evidência de sinal e tamanho.
- Trate um ponteiro como hipótese de endereço e verifique seu alvo no espaço de memória ativo.
- Aplique uma definição por vez ao aprender um binário, para que uma faixa incorreta seja fácil de desfazer.
- Anote os bytes indefinidos que permanecem entre dois campos conhecidos; lacunas podem ser padding ou um campo ausente.
address: 0x00402010 | size: 4 | observed: little-endian load | type: uint32_t | confidence: mediumbytes -> type -> Listing check -> reference check -> Decompiler checkTipos de dados do Ghidra: crie e aplique uma estrutura
Crie uma estrutura quando vários campos são acessados em offsets estáveis a partir da mesma base. Uma estrutura é mais do que uma lista de palpites: ela define ordem, offsets, tamanhos e normalmente um comprimento total. Comece pelo menor conjunto de campos sustentado por loads e stores repetidos. Você pode acrescentar nomes e tipos depois, conforme a evidência melhora, mas mudar o tamanho de um campo pode mover todos os campos seguintes e alterar a interpretação dos chamadores.
No Data Type Manager, crie uma estrutura nova na categoria do programa, dê a ela um nome temporário descritivo e adicione os campos em ordem de offset. Use padding explícito somente quando a lacuna for sustentada por alinhamento ou pelos acessos observados. Se um campo for um ponteiro, aplique um ponteiro para o tipo de destino mais defensável, não para uma estrutura arbitrária escolhida porque o nome parece familiar. Um nó autorreferente pode usar um ponteiro para a própria estrutura, mas confirme que o binário realmente segue esse ponteiro.
Depois de definir a estrutura, aplique-a no endereço base do Listing. Verifique cada limite de campo e compare o tamanho total com o próximo objeto conhecido ou com outra instância repetida. Se duas instâncias ocorrerem em um stride constante, isso é evidência útil de um array da estrutura. Se o próximo objeto começar em um offset inesperado, mantenha a lacuna visível até saber se ela é padding, uma union, outra versão ou um tipo de campo incorreto.
- 1
Crie uma estrutura do programa
No Data Type Manager, escolha a categoria do programa, crie uma estrutura e use um nome temporário que descreva a evidência, em vez de inventar um significado de negócio.
Program Types -> New -> Structure - 2
Adicione campos em ordem de offset
Adicione os campos primitivos, arrays, enums ou ponteiros conhecidos. Mantenha bytes desconhecidos como indefinidos ou padding explícito até uma referência sustentá-los.
offset 0x00 -> field_0; offset 0x04 -> field_4 - 3
Aplique na base
Selecione o endereço base no Listing, aplique a estrutura e confirme que cada campo termina onde o próximo acesso espera.
Listing -> Data -> apply structure - 4
Compare instâncias repetidas
Procure o mesmo padrão de acesso ou stride em outro endereço antes de renomear a estrutura como um objeto confirmado.
base + stride -> second instance
| Decisão da estrutura | Evidência útil | Risco se for um palpite |
|---|---|---|
| Tamanho do campo | Largura do load/store e offset repetido | Todos os campos seguintes mudam de posição |
| Padding | Limite de alinhamento ou lacuna consistente | Um campo real fica oculto ou a estrutura fica grande demais |
| Alvo do ponteiro | Desreferência e referências válidas ao alvo | O Decompiler mostra um grafo de objetos enganoso |
| Comprimento da estrutura | Próximo objeto, stride do array ou tamanho do alocador | Arrays e chamadores ficam inconsistentes |
Tipos de dados do Ghidra: use arrays, enums, typedefs e ponteiros
Um array é adequado quando o mesmo tipo de elemento se repete com um stride previsível. Defina primeiro o tipo do elemento e só estabeleça uma quantidade quando ela for sustentada por um limite de loop, comprimento de tabela, objeto vizinho ou tamanho de alocação. Uma quantidade presumida pode fazer bytes não relacionados parecerem elementos válidos. Para uma string terminada em nulo ou um buffer de tamanho definido em tempo de execução, deixe o limite explícito em vez de forçar um array fixo que a evidência não sustenta.
Enums melhoram a leitura quando um valor é comparado com um pequeno conjunto repetido de constantes. Nomeie somente os valores sustentados pela comparação ou documentação e mantenha um valor desconhecido visível. Typedefs podem dar um nome estável de projeto a um primitivo ou ponteiro repetido, mas não criam evidência nova. Eles são mais úteis depois que o tipo subjacente e a convenção de chamada já estão claros.
Ponteiros exigem mais disciplina porque um valor de ponteiro só tem significado dentro de um espaço de endereçamento. Confirme se ele aponta para uma estrutura, string, função ou tabela e verifique pelo menos uma referência real. Uma cadeia de ponteiros elegante no Decompiler ainda pode estar errada se a base, o segmento ou a largura do tipo estiverem incorretos. Mantenha visíveis nas notas o tipo de destino e a suposição sobre o espaço de endereçamento.
É melhor mostrar um byte indefinido ou um valor de enum desconhecido do que fazer o objeto inteiro parecer certo. Uma incerteza visível pode ser testada; um campo inventado não.
| Padrão de tipo | Use quando | Limite a registrar |
|---|---|---|
| Array | Elementos repetem com stride conhecido | Tipo e quantidade do elemento ou regra de término |
| Enum | Um valor é comparado com constantes nomeadas | Valores conhecidos e um caso desconhecido explícito |
| Typedef | Um tipo comprovado precisa de um nome reutilizável | Tipo subjacente e convenção de chamada |
| Ponteiro | O valor é desreferenciado ou usado como endereço | Espaço de endereçamento e tipo de destino |
| Ponteiro de função | Uma tabela ou chamada usa despacho indireto | Protótipo, stride da tabela e evidência da chamada |
Tipos de dados do Ghidra: verifique no Listing e no Decompiler
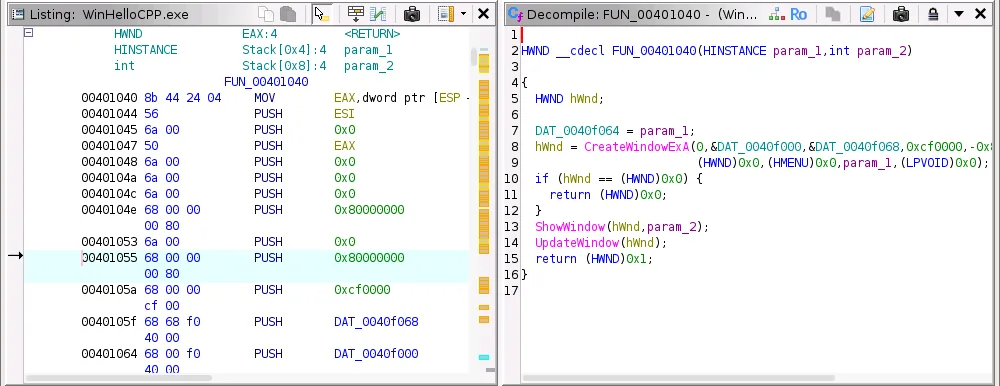
Depois de aplicar um tipo, volte ao Listing e inspecione os bytes exatos, o endereço, os offsets dos campos e as referências. Confirme que a definição permanece dentro do bloco de memória pretendido e que os valores exibidos correspondem às instruções de load/store. Se a definição sobrepor uma instrução ou string conhecida, pare e desfaça. O Listing é o registro em nível de endereço; ele deve continuar compreensível mesmo quando o Decompiler ainda não tiver sido atualizado.
Em seguida, selecione uma função que leia o objeto tipado e abra o Decompiler. Uma assinatura, estrutura ou ponteiro melhor pode substituir valores indefinidos e casts por nomes de campos, mas essa melhoria é uma verificação de consistência, não uma prova. Compare uma ou duas instruções decisivas com o pseudocódigo, incluindo sinal, aritmética de ponteiros, indexação de arrays e valores de retorno. Se a saída mudar quando a análise terminar, registre a mudança e confira novamente a evidência original. Reavalie os tipos quando um chamador ou outra visão discordar.
Revise os tipos como um modelo conectado, não como rótulos isolados. Os tipos no Listing devem corresponder aos tipos da assinatura da função, aos tipos usados pelas desreferências e aos tipos sugeridos pelos strides dos arrays. Quando houver discordância, mantenha os tipos mais simples sustentados pela evidência, marque os incertos como provisórios e teste-os contra outra referência antes de nomear o objeto com confiança.
Use o guia do Function Graph quando um campo for lido em vários ramos e o guia de análise de firmware quando o próprio mapa de endereços for incerto. Essas páginas respondem a questões próximas; esta página continua responsável pelo modelo de dados e seus limites.
Tipos de dados do Ghidra: corrija tamanhos, offsets e visões antigas
Quando um tipo parecer errado, comece pela menor discordância. Verifique a linguagem do processador, o espaço de endereçamento, a ordem dos bytes, a faixa selecionada e a assinatura da função antes de mudar vários campos de uma só vez. Um ponteiro de 64 bits aplicado a uma tabela de 32 bits, ou uma estrutura compactada aplicada a dados naturalmente alinhados, pode fazer todo acesso posterior parecer quebrado. Desfaça a última alteração, compare os bytes e teste uma suposição por vez.
Uma visão antiga do Decompiler também pode enganar. Espere a análise em segundo plano terminar, atualize ou selecione novamente a função e confirme que Listing e Decompiler apontam para o mesmo endereço. Se um archive de tipos fornecer um nome parecido, inspecione tamanho e compactação subjacentes em vez de presumir compatibilidade. Compare os tipos novamente quando um chamador discordar e mantenha uma cópia do projeto antes de grandes edições para que um experimento errado possa ser revertido.
Anote o endereço exato, o tipo, a linguagem e a alteração que produziu o problema. Uma nota curta de antes e depois é mais útil do que repetir palpites para uma nova estrutura.
| Sintoma | Verifique primeiro | Próxima ação mais segura |
|---|---|---|
| Campos mudam depois de aplicar uma estrutura | Tamanhos de campos, padding e linguagem | Desfaça, mantenha a lacuna indefinida e reconstrua pelos offsets |
| Ponteiro aponta para fora da memória | Espaço de endereçamento, base e largura do ponteiro | Trate-o como inteiro até encontrar um alvo válido |
| Decompiler mostra muitos casts | Assinatura, sinal e tipo de destino | Verifique um chamador e um load/store no Listing |
| Array consome bytes não relacionados | Quantidade, stride e término | Use quantidade menor ou um limite de execução |
| Tipo não aparece no gerenciador | Categoria, caminho do archive e filtro | Atualize e importe apenas um archive verificado |
Tipos de dados do Ghidra: um fluxo de trabalho repetível
Uma sessão confiável de modelagem de dados é pequena, explícita e fácil de revisar. Comece com uma pista, como um offset repetido, um comprimento conhecido, uma desreferência ou uma comparação constante. Registre endereço e bytes, selecione o tipo mais estreito que explica a pista e verifique o resultado no Listing antes de adicionar nomes. Só depois avance para uma estrutura, array, enum ou ponteiro que combine várias observações sustentadas.
Para uma equipe ou investigação repetida, preserve a versão do projeto, a linguagem do processador, a fonte do tipo e a confiança de cada definição importante. Mantenha tipos do programa separados de imports especulativos de archives e compare-os novamente quando um chamador discordar. Use o guia do Script Manager somente depois que a operação manual estiver entendida. Um script pode aplicar um bom modelo de forma consistente, mas também pode espalhar rapidamente uma suposição ruim.
O objetivo não é fazer cada linha parecer código-fonte. O objetivo é um modelo que explique bytes, referências e fluxo de controle enquanto mostra o que ainda é desconhecido. Mantenha tipos, offsets e alvos de ponteiros revisáveis para que o próximo analista tenha um ponto claro para testar, corrigir ou automatizar a interpretação.
- 1
Ancore
Comece por um endereço, referência, limite de loop ou acesso repetido que possa ser apontado no Listing.
evidence -> address - 2
Modele
Aplique o menor tipo primitivo ou de campo que explique a largura e a representação observadas.
address -> type - 3
Confira
Compare bytes, offsets, referências e um consumidor no Decompiler antes de adicionar nomes ou padding.
Listing -> Decompiler - 4
Preserve
Salve uma cópia do projeto e registre motivo, confiança e caminho de reversão do modelo.
type + evidence + rollback
- Use binários autorizados e mantenha os arquivos originais inalterados.
- Separe offsets de arquivo, endereços carregados e alvos de ponteiros nas notas.
- Prefira uma incerteza visível a um campo ou quantidade que seja apenas um palpite.
- Verifique novamente os chamadores depois de mudar uma estrutura ou assinatura de função.
- Automatize somente depois que um exemplo manual estiver correto e repetível.
Tipos de dados do Ghidra: perguntas frequentes
Para que servem os tipos de dados do Ghidra?
Os tipos de dados do Ghidra descrevem como os bytes devem ser exibidos e interpretados no modelo do programa. Eles permitem definir primitivos, strings, estruturas, arrays, enums e ponteiros e verificar essas definições no Listing e no Decompiler.
Como crio uma estrutura no Ghidra?
Abra o Data Type Manager, crie uma estrutura na categoria do programa atual, adicione campos em ordem de offset, mantenha lacunas sem suporte como indefinidas ou padding justificado e aplique a estrutura no endereço base do Listing.
Por que os campos da minha estrutura no Ghidra têm offsets errados?
Verifique a linguagem do processador, tamanhos dos campos, alinhamento, compactação e qualquer padding explícito. Desfaça a definição, compare os bytes originais e reconstrua a menor estrutura sustentada por acessos repetidos.
Devo definir um tipo de ponteiro no Ghidra?
Defina um ponteiro quando o valor for usado como endereço e pelo menos uma referência sustentar seu espaço de endereçamento e alvo. Se essa evidência faltar, mantenha o valor como inteiro ou tipo de tamanho desconhecido até verificar o alvo.
Um tipo de dados do Ghidra pode alterar o binário original?
Aplicar um tipo de dados altera o modelo do projeto e suas visões, não o arquivo de entrada original. Mantenha uma cópia do projeto e exporte ou salve notas ao fazer grandes alterações de modelagem.
Por que o Decompiler ainda mostra valores indefinidos depois que aplico um tipo?
Selecione novamente a função e deixe a análise terminar; depois confirme que o tipo foi aplicado ao endereço realmente lido pela função. Uma assinatura errada, profundidade de ponteiro ou mapa de memória incorreto pode manter casts e valores indefinidos no pseudocódigo.